
[Spark] Spark 安装配置
原文地址:https://www.cnblogs.com/memento/p/9148732.html
Windows 上的单机版安装
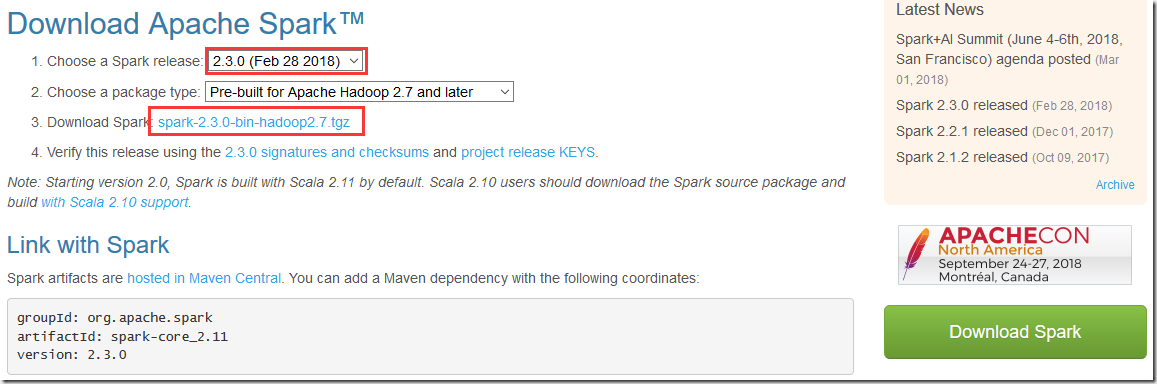
下载地址:http://spark.apache.org/downloads.html
本文以 Spark 2.3.0 为例
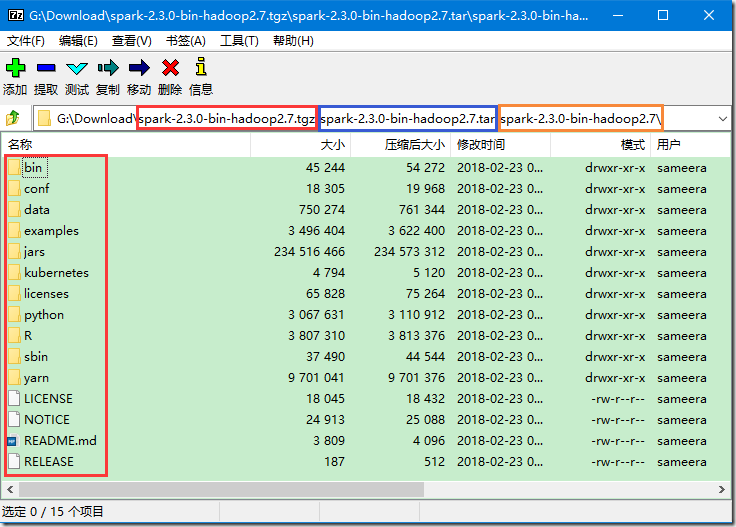
>>> 下载下来的文件是 tgz 格式的压缩文件,直接利用压缩软件将其打开,可以看见里面有一个 tar 格式的压缩文件,继续用压缩软件打开,最终如下图所示:
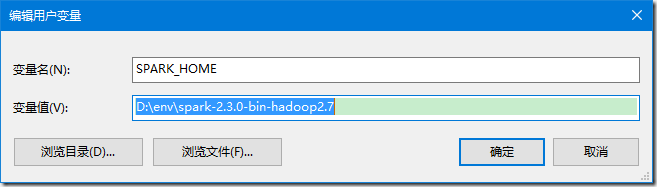
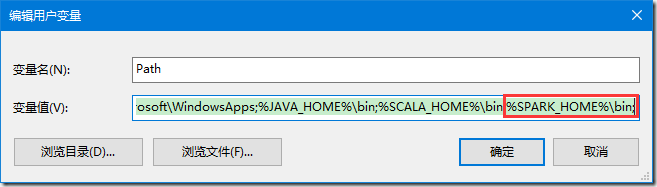
>>> 将其中的 spark-2.3.0-bin-hadoop2.7 文件夹解压,新增 SPARK_HOME 环境变量,设置为解压路径,并将其追加到 PATH 环境变量;
>>> 此时在 cmd 窗口中执行 "spark-shell" 命令可得到如下提示:
C:\Users\Memento>spark-shell

2018-06-06 23:39:36 ERROR Shell:397 - Failed to locate the winutils binary in the hadoop binary path

java.io.IOException: Could not locate executable null\bin\winutils.exe in the Hadoop binaries.

        at org.apache.hadoop.util.Shell.getQualifiedBinPath(Shell.java:379)

        at org.apache.hadoop.util.Shell.getWinUtilsPath(Shell.java:394)

        at org.apache.hadoop.util.Shell.<clinit>(Shell.java:387)

        at org.apache.hadoop.util.StringUtils.<clinit>(StringUtils.java:80)

        at org.apache.hadoop.security.SecurityUtil.getAuthenticationMethod(SecurityUtil.java:611)

        at org.apache.hadoop.security.UserGroupInformation.initialize(UserGroupInformation.java:273)

        at org.apache.hadoop.security.UserGroupInformation.ensureInitialized(UserGroupInformation.java:261)

        at org.apache.hadoop.security.UserGroupInformation.loginUserFromSubject(UserGroupInformation.java:791)

        at org.apache.hadoop.security.UserGroupInformation.getLoginUser(UserGroupInformation.java:761)

        at org.apache.hadoop.security.UserGroupInformation.getCurrentUser(UserGroupInformation.java:634)

        at org.apache.spark.util.Utils$$anonfun$getCurrentUserName$1.apply(Utils.scala:2464)

        at org.apache.spark.util.Utils$$anonfun$getCurrentUserName$1.apply(Utils.scala:2464)

        at scala.Option.getOrElse(Option.scala:121)

        at org.apache.spark.util.Utils$.getCurrentUserName(Utils.scala:2464)

        at org.apache.spark.SecurityManager.<init>(SecurityManager.scala:222)

        at org.apache.spark.deploy.SparkSubmit$.secMgr$lzycompute$1(SparkSubmit.scala:393)

        at org.apache.spark.deploy.SparkSubmit$.org$apache$spark$deploy$SparkSubmit$$secMgr$1(SparkSubmit.scala:393)

        at org.apache.spark.deploy.SparkSubmit$$anonfun$prepareSubmitEnvironment$7.apply(SparkSubmit.scala:401)

        at org.apache.spark.deploy.SparkSubmit$$anonfun$prepareSubmitEnvironment$7.apply(SparkSubmit.scala:401)

        at scala.Option.map(Option.scala:146)

        at org.apache.spark.deploy.SparkSubmit$.prepareSubmitEnvironment(SparkSubmit.scala:400)

        at org.apache.spark.deploy.SparkSubmit$.submit(SparkSubmit.scala:170)

        at org.apache.spark.deploy.SparkSubmit$.main(SparkSubmit.scala:136)

        at org.apache.spark.deploy.SparkSubmit.main(SparkSubmit.scala)

2018-06-06 23:39:36 WARN  NativeCodeLoader:62 - Unable to load native-hadoop library for your platform... using builtin-java classes where applicable

Setting default log level to "WARN".

To adjust logging level use sc.setLogLevel(newLevel). For SparkR, use setLogLevel(newLevel).

Spark context Web UI available at http://Memento-PC:4040

Spark context available as 'sc' (master = local[*], app id = local-1528299586814).

Spark session available as 'spark'.

Welcome to

      ____              __

     / __/__  ___ _____/ /__

    _\ \/ _ \/ _ `/ __/  '_/

   /___/ .__/\_,_/_/ /_/\_\   version 2.3.0

      /_/

Using Scala version 2.11.8 (Java HotSpot(TM) 64-Bit Server VM, Java 1.8.0_151)

Type in expressions to have them evaluated.

Type :help for more information.
提示说在 hadoop 路径下无法定位到 winutils,所以接下来需要配置 Hadoop;
>>> 详见:Windows 下的 Hadoop 2.7.5 环境搭建
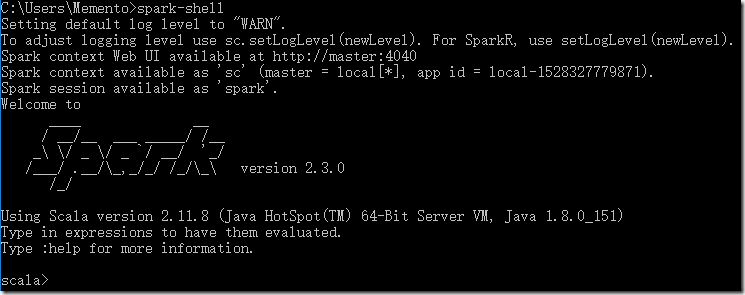
>>> 随后再重新执行 "spark-shell" 命令即可;
By. Memento
[Spark] Spark 安装配置的更多相关文章
- spark HA 安装配置和使用(spark1.2-cdh5.3)
安装环境如下: 操作系统:CentOs 6.6 Hadoop 版本:CDH-5.3.0 Spark 版本:1.2 集群5个节点 node01~05 node01~03 为worker. node04. ...
- Spark_安装配置_运行模式
一.Spark支持的安装模式: 1.伪分布式(一台机器即可) 2.全分布式(至少需要3台机器) 二.Spark的安装配置 1.准备工作 安装Linux和JDK1.8 配置Linux:关闭防火墙.主机名 ...
- Hive on Spark安装配置详解(都是坑啊)
个人主页:http://www.linbingdong.com 简书地址:http://www.jianshu.com/p/a7f75b868568 简介 本文主要记录如何安装配置Hive on Sp ...
- Spark standlone安装与配置
spark的安装简单,去官网下载与集群hadoop版本相一致的文件即可. 解压后,主要需要修改spark-evn.sh文件. 以spark standlone为例,配置dn1,nn2为master,使 ...
- Spark(三): 安装与配置
参见 HDP2.4安装(五):集群及组件安装 ,安装配置的spark版本为1.6, 在已安装HBase.hadoop集群的基础上通过 ambari 自动安装Spark集群,基于hadoop yarn ...
- spark集群安装配置
spark集群安装配置 一. Spark简介 Spark是一个通用的并行计算框架,由UCBerkeley的AMP实验室开发.Spark基于map reduce 算法模式实现的分布式计算,拥有Hadoo ...
- 安装配置最强Spark IDE--IDEA
1.安装IntelliJ IDEA IDEA 全称 IntelliJ IDEA,是java语言开发的集成环境,IntelliJ在业界被公认为最好的java开发工具之一,尤其在智能代码助手.代码自动提示 ...
- centOS7下Spark安装配置
环境说明: 操作系统: centos7 64位 3台 centos7-1 192.168.190.130 master centos7-2 192.168.190.129 slave1 centos7 ...
- 安装配置Spark集群
首先准备3台电脑或虚拟机,分别是Master,Worker1,Worker2,安装操作系统(本文中使用CentOS7). 1.配置集群,以下步骤在Master机器上执行 1.1.关闭防火墙:syste ...
- ubuntu下spark安装配置
一.安装vmware虚拟机 二.在虚拟机上安装ubuntu12.04操作系统 三.安装jdk1.8.0_25 http://www.oracle.com/technetwork/java/javase ...
随机推荐
- Ubuntu 16.04 python和OpenCV安装
Ubuntu 16.04 python和OpenCV安装:最进在做深度学习和计算机视觉的有关内容,因此要在python中用到opencv.我的电脑装的是Ubuntu 16.04,python 2.7和 ...
- 1 认识Jquery
一 代码风格和变量风格 1 链式操作风格 : (1)对同一对象不超三个操作的可以写在一行 (2)对于同一个对象的较多操作,建议每行写一个操作 (3)对于多个对象的少量操作,可以每个对象写一行,涉及子元 ...
- servlet(二)
http协议 (1)什么是http协议? 是一种网络应用层协议,规定了浏览器如何与web服务器之间进行通信以及相应的 数据包的结构. 浏览器与web服务器之间如何通信? step1.建立连接 step ...
- C语言函数部分
一.变量的作用域 1.概念:变量起作用的范围. 2.局部变量与全局变量: ①局部变量: 概念:在函数内部或某个控制块的内部定义的变量(理解“局部”) 作用域:函数内部 作用:增强了函数模块的独立性 ② ...
- hdu 6127---Hard challenge(思维)
题目链接 Problem Description There are n points on the plane, and the ith points has a value vali, and i ...
- odoo开发笔记 -- 进入后台调试模式
./odoo-bin shell -d test1 -c /home/odoo/odooshare/odoo.conf ./odoo-bin shell -d 数据库名 -c 指定配置文件
- Android多线程编程<一>Android中启动子线程的方法
我们知道在Android中,要更新UI只能在UI主线程去更新,而不允许在子线程直接去操作UI,但是很多时候,很多耗时的工作都交给子线程去实现,当子线程执行完这些耗时的工作后,我们希望去修改 ...
- SQL 必知必会·笔记<7>汇总数据——使用聚合函数
有时候我们需要对表中的数据进行汇总,而不需要数据本身,为了方便这些类型的检索,SQL给出了5个聚合函数,SQL聚合函数在各主要的SQL实现中得到了相当一致的支持.如下: 1.1 AVG()函数 AVG ...
- Redis 哨兵
作用 Redis Sentinel,即Redis哨兵,在Redis 2.8版本开始引入. 主要提供了配置提供者,通知,哨兵的监控和自动故障转移功能.哨兵的核心功能是主节点的自动故障转移. 下面是Red ...
- [深度学习]CNN--卷积神经网络中用1*1 卷积有什么作用
1*1卷积过滤器 和正常的过滤器一样,唯一不同的是它的大小是1*1,没有考虑在前一层局部信息之间的关系.最早出现在 Network In Network的论文中 ,使用1*1卷积是想加深加宽网络结构 ...