
爬虫那点事,干就玩了之seleunim
本文已独家授权给脚本之家(jb51net)、新华前后端开发公众号发布
做技术我们最重要的是【做】。但是今天我们来讲片【玩】。这句话可能不太好理解。直接开门见山吧。对于外行朋友一谈到IT他们对我们的定位就是黑客。其实我们和黑客一点关系都没有。今天的技术是【爬虫】 。 为什么说爬虫和黑客有点关联呢。因为爬虫可以将人为行为进行机器化。就是实现编写好代码让机器代替我们人类重复的操作意见事情。
对于爬虫了我们这里不做基础的讲解了。在平时的开发中我们偶尔会用到爬虫。比如说我们系统需要添加天气情况。但是我们有没有气象站给我提供数据。这时候我们最显示的做法就是调用网络上免费的天气接口API 。 这个时候我们Java就会通过爬虫模拟除一个浏览器请求去访问这个天气接口的API。 然后在通过爬虫获取这个API返回的数据。从而进行解析。
对于这些免费的API我们通过爬虫(HttpClient)就可以轻松的访问了。但是想优酷、爱奇艺、掘金这些等级网站他们会有发爬虫策略。最常见的就是利用爬虫进行刷票的行为。他们针对这些刷票做了一些措施。具体措施就不说了(不知道)。更有甚者他们对他们的页面进行加密。让你无法分析他们的html.或者加大你分析的成本。以上就是之前我们用爬虫爬取数据遇到的一些问题。下面简单梳理下我们遇到爬虫的问题
- 网络反爬虫
- 网络人为审核
- 登录验证码
- 需要了解网站(需要有代码经验进行html分析)
selenium
今天我们带了一个好东西。它转变了我们传统爬虫的思路。传统的爬虫我们会去按照开发者的思路去处理逻辑。但是selenium他不需要关注开发者逻辑。只需要我们关注自己的需求。什么意思呢?就是说selenium他就是在模拟用户的行为,你告诉selenium我需要点击页面的某个按钮了,他就去点击了。你告诉他我需要在某个输入框中输入内容了。他就去给你输入内容。有了它,你再也不用管输入内容之后提交登录真正请求了。这样的好处是降低了爬虫的学习成本。对于不懂技术的人也可以很快上手了。
环境准备
这个是干嘛的呢?这里先透露下selenium使用的是浏览器的内核操作页面的。所以这里需要现在内核。下载内核前提是电脑上有浏览器。笔者这里电脑上浏览器是Google 1.73版本 。 所以下载内核就得是对应的版本,否则会报错的。在notes.txt文件中会列出每个对应的浏览器的版本的。
代码环境
<dependency>

  <groupId>org.seleniumhq.selenium</groupId>

  <artifactId>selenium-java</artifactId>

  <version>3.141.59</version>

</dependency>
开始爬虫
想想我们平时浏览网页的时候是需要先打开浏览器,这里也是一样。
【我们需要打开浏览器】(我的内核放在/root/Downloads/chromedriver)
ChromeOptions chromeOptions = new ChromeOptions();

File chromeDriverPath = new File("/root/Downloads/chromedriver");

System.setProperty("webdriver.chrome.driver", chromeDriverPath.getAbsolutePath());

chromeOptions.addArguments("--headless");

chromeOptions.addArguments("--disable-gpu");

//ubuntu浏览器中需要添加

chromeOptions.addArguments("--no-sandbox");

webDriver = new ChromeDriver(chromeOptions);
headless : 表示隐式打开浏览器,因为做爬虫就不需要显示界面了。
no-sandbox : 这个是因为我的Ubuntu安装的google需要这个参数,所以这里也需要加上
disable-gpu : 同上
【输入链接地址】(https://juejin.im/)
webDriver.get("https://juejin.im/");,这样内核就获取到了我们在浏览器中看到的效果。那么我们这么获取我们需要的页面数据呢。
findElement通过这个方法我们可以获取到我们想要的任何数据。换句话说通过这个方法这个页面在你面前一览无余。包括他的衍生页面
有的读者有疑问了。我该怎么让他获取我想要的东西呢。
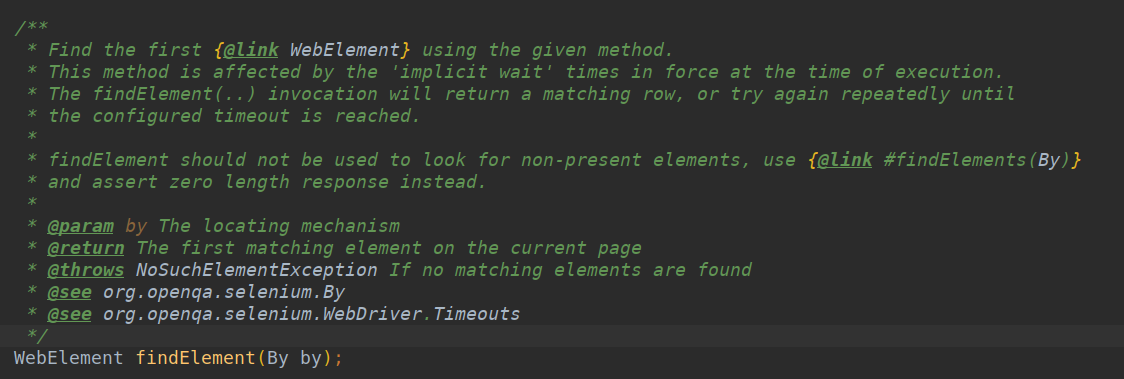
我们可以看出来这个方法里只有一个参数,By对象。这个By对象里提供了如下方法
- id
- linkText
- partialLinkText
- name
- tagName
- xpath
- className
- cssSelector
上面这些方法就是我们定位元素的方法。什么意思呢,我们前段朋友们经常通过jquery操作html的dom对象,在By对象里cssSelector就是和jquery同样的操作方法。好多都是和jquery类似的。这里不懂技术的人会说这里技术点很难。其实不难。 我们不懂代码的怎么办呢。我们在浏览器浏览页面 。 比如下图中我想获取我的博客名称(框架原理那点事--不就反射嘛。)

我们鼠标放在【框架原理那点事--不就反射嘛】上右键选择【检查】。会自动跳转到对应的代码的
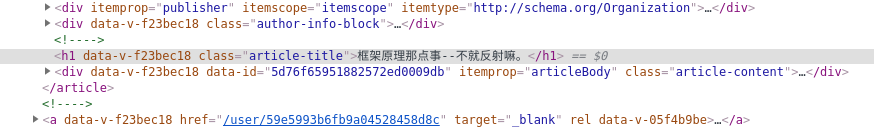

后面三种对应By里面的制定方法。这里就不说了。
操作js
WebElement webElement = webDriver.findElement(By.cssSelector("xxxxxx"));

JavascriptExecutor js = (JavascriptExecutor) webDriver;

js.executeScript("arguments[0].click();",digg);
上面的webElement是页面中一个按钮。我们可以直接webElement.click()让按钮点击或者webElement.submit()提交Form表单。但是有的时候会不起作用。这个时候用上面的代码可以进行点击。
截图
File source = ((TakesScreenshot) webDriver).getScreenshotAs(OutputType.FILE);

try {

    Files.copy(source.toPath(), new FileOutputStream(new File("/root/Downloads/test/1.png")));

} catch (IOException e) {

    e.printStackTrace();

}

try {

    TimeUnit.SECONDS.sleep(5);

} catch (InterruptedException e) {

    e.printStackTrace();

}
我们内核操作因为正常不开浏览器界面,但是我们调试的时候又想知道结果,可以打印除当前窗口的图片。就是上述的代码
切换窗口
Set<String> windowHandles = webDriver.getWindowHandles();

for (String windowHandle : windowHandles) {

    if (!windowHandle.equals(webDriver.getWindowHandle())) {

        //webDriver.switchTo().window(windowHandle);

    }

}
在当前窗口切换访问地址
webDriver.navigate().to("https://juejin.im/post/5d76f6585188254cc27b2af4");

webDriver.get("https://juejin.im/post/5d76f6585188254cc27b2af4");
管理cookie
webDriver.get("https://juejin.im/timeline");

webDriver.manage().addCookie(cookie);

webDriver.get("https://juejin.im/post/5d76f6585188254cc27b2af4");
这里值得注意的是,在添加cookie之前我们需要先访问主页,告诉内核我们后面添加的cookie是给那个Host下添加的。这样我们添加的cookie才会有效。如上我们在juejin.im这个Host下都添加了Cookie。
个人网站(https://zxhtom.oschina.io)
个人微信(zxh870775401)
微信公众号 : 新华前后端开发
# 加入战队
微信公众号
# 加入战队
微信公众号
爬虫那点事,干就玩了之seleunim的更多相关文章
- 爬虫_糗事百科(scrapy)
糗事百科scrapy爬虫笔记 1.response是一个'scrapy.http.response.html.HtmlResponse'对象,可以执行xpath,css语法来提取数据 2.提取出来的数 ...
- Python爬虫_糗事百科
本爬虫任务: 爬虫糗事百科网站(https://www.qiushibaike.com/)--段子版块中所有的[段子].[投票数].[神回复]等内容 步骤: 通过翻页寻找url规律,构造url列表 查 ...
- python 爬虫系列05--丑事百科
丑事百科爬虫 import re import requests def parse_page(url): headers = { 'User-Agent':'user-agent: Mozilla/ ...
- <爬虫实战>糗事百科
1.糗事百科段子.py # 目标:爬取糗事百科段子信息(文字) # 信息包括:作者头像,作者名字,作者等级,段子内容,好笑数目,评论数目 # 解析用学过的几种方法都实验一下①正则表达式.②Beauti ...
- 手动爬虫之糗事百科(ptyhon3)
一.调用封装的Url_ProxyHelper类,源码如下 import urllib.request as ur class Url_ProxyHelper: def __init__(self, u ...
- python爬虫30 | scrapy后续,把「糗事百科」的段子爬下来然后存到数据库中
上回我们说到 python爬虫29 | 使用scrapy爬取糗事百科的例子,告诉你它有多厉害! WOW!! scrapy awesome!! 怎么会有这么牛逼的框架 wow!! awesome!! 用 ...
- Python爬虫入门教程 63-100 Python字体反爬之一,没办法,这个必须写,反爬第3篇
背景交代 在反爬圈子的一个大类,涉及的网站其实蛮多的,目前比较常被爬虫coder欺负的网站,猫眼影视,汽车之家,大众点评,58同城,天眼查......还是蛮多的,技术高手千千万,总有五花八门的反爬技术 ...
- Python网络爬虫与如何爬取段子的项目实例
一.网络爬虫 Python爬虫开发工程师,从网站某一个页面(通常是首页)开始,读取网页的内容,找到在网页中的其它链接地址,然后通过这些链接地址寻找下一个网页,这样一直循环下去,直到把这个网站所有的网页 ...
- Python 爬虫实战
图片爬虫实战 链接爬虫实战 糗事百科爬虫实战 微信爬虫实战 多线程爬虫实战
随机推荐
- CountHunter 6101 最优贸易 强联通缩点
题目传送门 题解:强连通锁点之后. 就成了一副单向图. 然后对于每个点 找到 后面合法的点的最大值就好了. 合法就是后面的那个点可以走到n号点. 也可以正向跑一遍dij 求出到这个点的最小花费. 然后 ...
- Allegro PCB导入DXF文件详解
一:导入方法 1.确认Allegro PCB的单位精度设置和DXF文件保持一致(一般情况下DXF文件用mm,Allegro文件用mil). 2. 在Allegro中点击File→Import→DXF… ...
- 为什么使用消息队列?消息队列有什么优点和缺点?Kafka、ActiveMQ、RabbitMQ、RocketMQ 都有什么优点和缺点?
面试题 为什么使用消息队列? 消息队列有什么优点和缺点? Kafka.ActiveMQ.RabbitMQ.RocketMQ 都有什么区别,以及适合哪些场景? 面试官心理分析 其实面试官主要是想看看: ...
- Redis哨兵(Sentinel)模式快速入门
更多内容,欢迎关注微信公众号:全菜工程师小辉.公众号回复关键词,领取免费学习资料. 当主服务器宕机后,需要手动把一台从服务器切换为主服务器,这就需要人工干预,费事费力,还会造成一段时间内服务不可用. ...
- Go依赖管理及Go module使用
Go语言的依赖管理随着版本的更迭正逐渐完善起来. 依赖管理 为什么需要依赖管理 最早的时候,Go所依赖的所有的第三方库都放在GOPATH这个目录下面.这就导致了同一个库只能保存一个版本的代码.如果不同 ...
- springcloud(五):Spring Cloud 配置中心的基本用法
Spring Cloud 配置中心的基本用法 1. 概述 本文介绍了Spring Cloud的配置中心,介绍配置中心的如何配置服务端及配置参数,也介绍客户端如何和配置中心交互和配置参数说明. 配置中心 ...
- 算法与数据结构基础 - 递归(Recursion)
递归基础 递归(Recursion)是常见常用的算法,是DFS.分治法.回溯.二叉树遍历等方法的基础,典型的应用递归的问题有求阶乘.汉诺塔.斐波那契数列等,可视化过程. 应用递归算法一般分三步,一是定 ...
- ListView 字母导航排序
一.概述 ListView字母导航排序,网上已经有很多代码和博客了, 这篇博文也是照搬网上的. 之所以写到这里,不是为了说明什么,只是为了以后自己查阅方便.本来公司要求实现expandablelis ...
- .Net基础篇_学习笔记_第四天_switch-case
swith-case 用来处理多条件的定值的判断. 语法: switch(变量或者表达式的值) { case 值1:要执行的代码: break: case 值2:要执行的代码: break: case ...
- .Net基础篇_学习笔记_第三天_运算符
入门编程思想,由传统“算法”引申到“编程”思想 using System; using System.Collections.Generic; using System.Linq; using Sys ...