
利用requestes\pyquery\BeautifulSoup爬取某租房公寓(深圳市)4755条租房信息及总结
为了分析深圳市所有长租、短租公寓的信息,爬取了某租房公寓深圳区域所有在租公寓信息,以下记录了爬取过程以及爬取过程中遇到的问题:
爬取代码:
 1 import requests

 2 from requests.exceptions import RequestException

 3 from pyquery import PyQuery as pq

 4 from bs4 import BeautifulSoup

 5 import pymongo

 6 from config import *

 7 from multiprocessing import Pool

 8

 9 client = pymongo.MongoClient(MONGO_URL)    # 申明连接对象

10 db = client[MONGO_DB]    # 申明数据库

11

12 def get_one_page_html(url):    # 获取网站每一页的html

13     headers = {

14         "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) "

15                       "Chrome/85.0.4183.121 Safari/537.36"

16     }

17     try:

18         response = requests.get(url, headers=headers)

19         if response.status_code == 200:

20             return response.text

21         else:

22             return None

23     except RequestException:

24         return None

25

26

27 def get_room_url(html):    # 获取当前页面上所有room_info的url

28     doc = pq(html)

29     room_urls = doc('.r_lbx .r_lbx_cen .r_lbx_cena a').items()

30     return room_urls

31

32

33 def parser_room_page(room_html):

34     soup = BeautifulSoup(room_html, 'lxml')

35     title = soup.h1.text

36     price = soup.find('div', {'class': 'room-price-sale'}).text[:-3]

37     x = soup.find_all('div', {'class': 'room-list'})

38     area = x[0].text[7:-11]    # 面积

39     bianhao = x[1].text[4:]

40     house_type = x[2].text.strip()[3:7]    # 户型

41     floor = x[5].text[4:-2]    # 楼层

42     location1 = x[6].find_all('a')[0].text    # 分区

43     location2 = x[6].find_all('a')[1].text

44     location3 = x[6].find_all('a')[2].text

45     subway = x[7].text[4:]

46     addition = soup.find_all('div', {'class': 'room-title'})[0].text

47     yield {

48         'title': title,

49         'price': price,

50         'area': area,

51         'bianhao': bianhao,

52         'house_type': house_type,

53         'floor': floor,

54         'location1': location1,

55         'location2': location2,

56         'location3': location3,

57         'subway': subway,

58         'addition': addition

59     }

60

61

62 def save_to_mongo(result):

63     if db[MONGO_TABLE].insert_one(result):

64         print('存储到mongodb成功', result)

65         return True

66     return False

67

68

69 def main(page):

70     url = 'http://www.xxxxx.com/room/sz?page=' + str(page)    # url就不粘啦,嘻嘻

71     html = get_one_page_html(url)

72     room_urls = get_room_url(html)

73     for room_url in room_urls:

74         room_url_href = room_url.attr('href')

75         room_html = get_one_page_html(room_url_href)

76         if room_html is None:    # 非常重要,否则room_html为None时会报错

77             pass

78         else:

79             results = parser_room_page(room_html)

80             for result in results:

81                 save_to_mongo(result)

82

83 if __name__ == '__main__':

84     pool = Pool()  # 使用多进程提高爬取效率

85     pool.map(main, [i for i in range(1, 258)])
在写爬取代码过程中遇到了两个问题:
(一)在get_room_url(html)函数中,开始是想直接return每个租房信息的room_url,但是return不同于print,函数运行到return时就会结束该函数,这样就只能返回每页第一个租房room_url。解决办法是:return 包含每页所有room_url的generator生成器,在main函数中用for循环遍历,再从每个room_url中获取href,传入到get_one_page_html(room_url_href)中进行解析。
(二)没有写第76行的if语句,我默认get_one_page_html(room_url_href)返回的room_html不为空,因此出现multiprocessing.pool.RemoteTraceback报错:
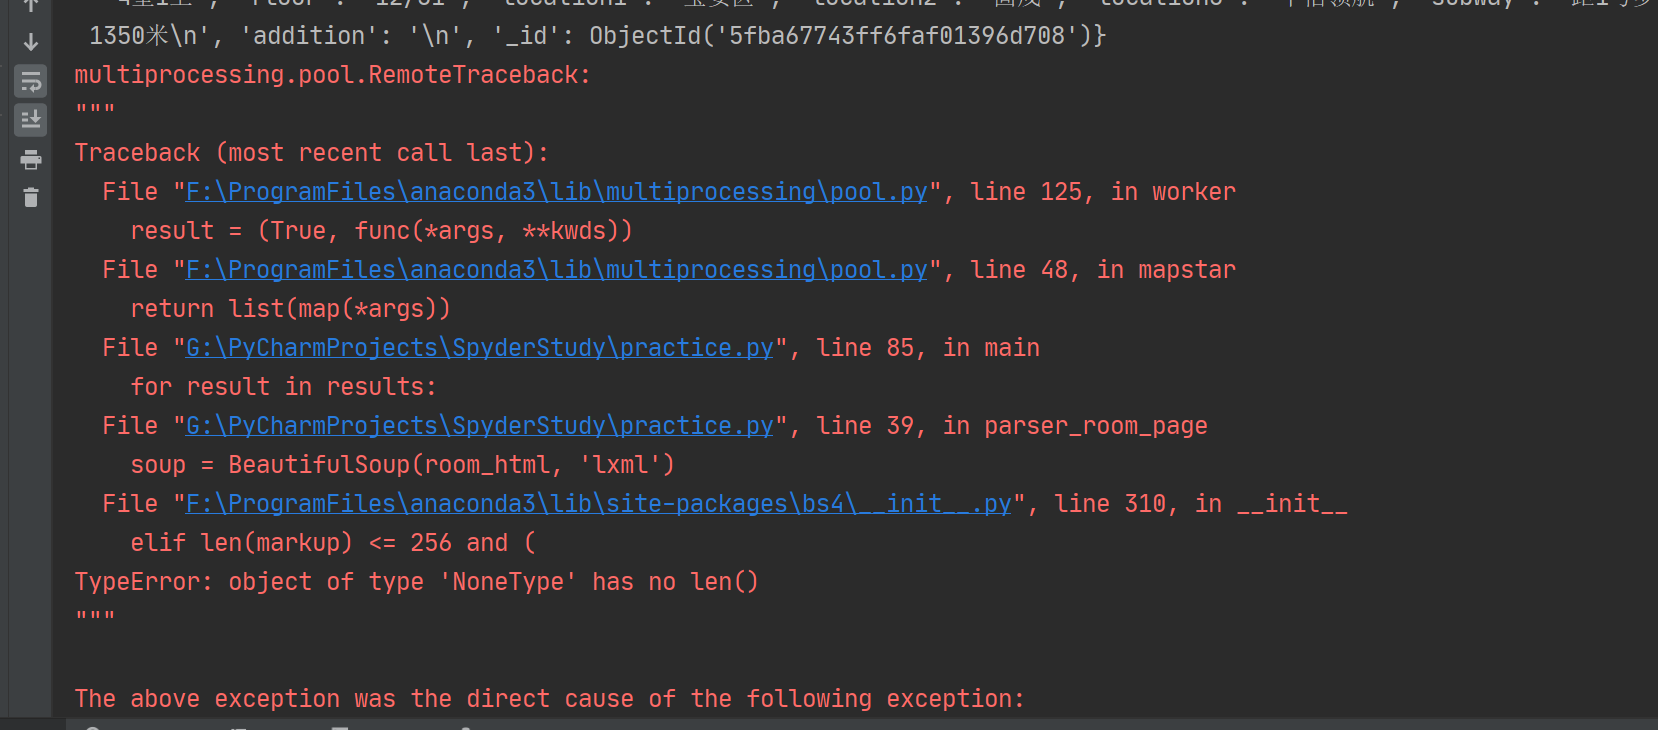
上图中显示markup为None情况下报错,点击蓝色"F:\ProgramFiles\anaconda3\lib\site-packages\bs4\__init__.py"发现markup为room_html,即部分room_html出现None情况。要解决这个问题,必须让代码跳过room_html is None的情况,因此添加 if 语句解决了这个问题。
最终成功爬取某租房公寓深圳市258页共4755条租房信息,为下一步进行数据分析做准备。
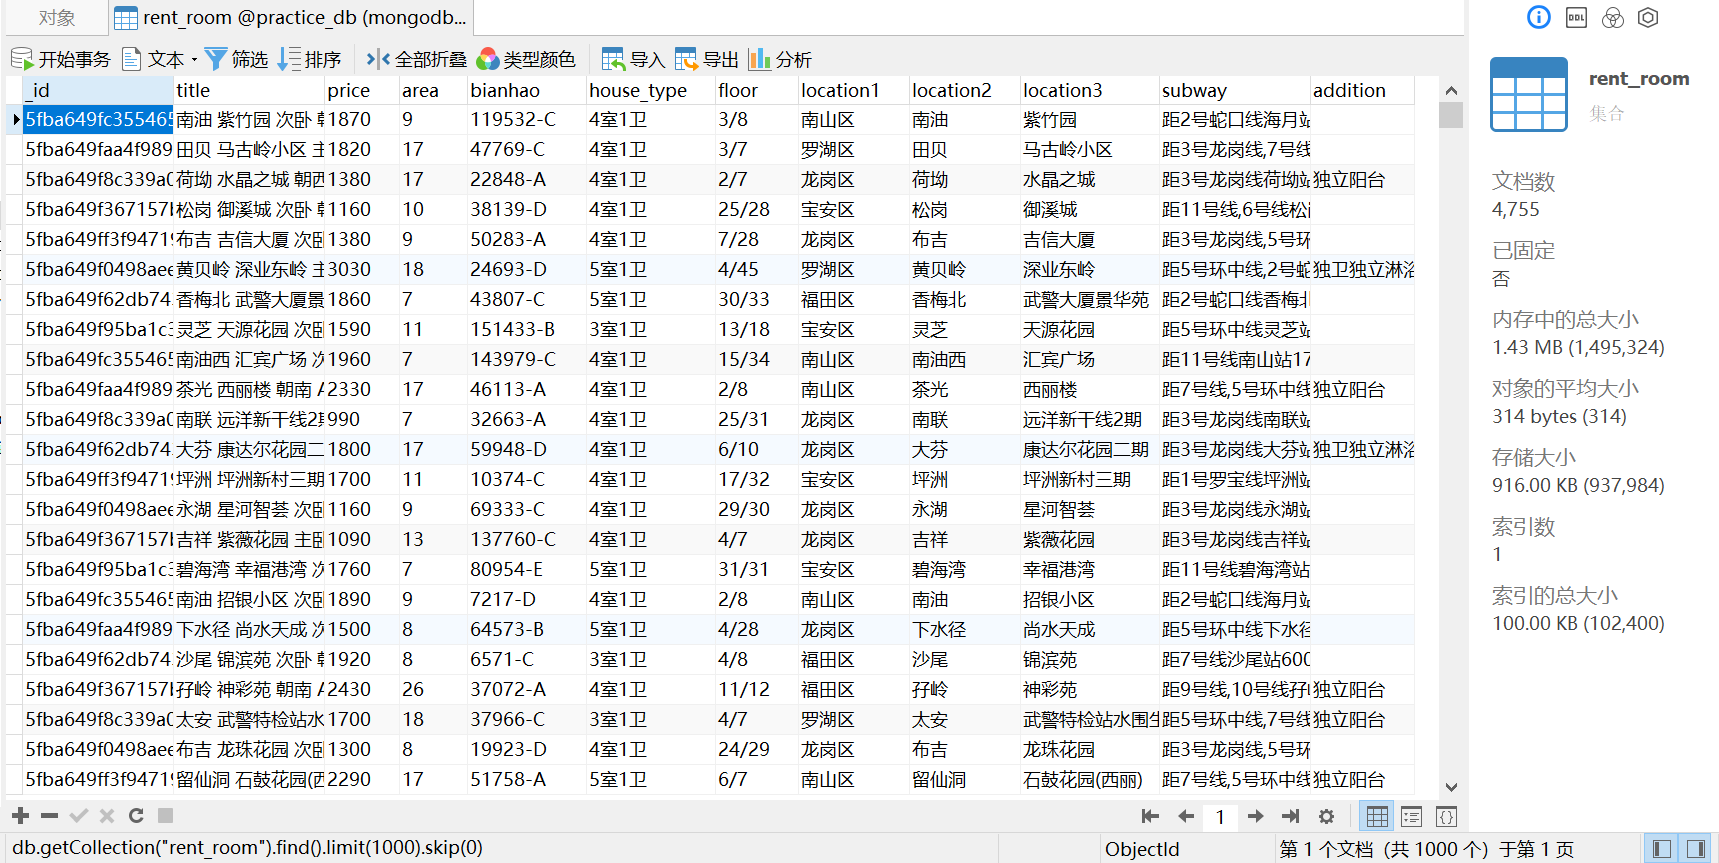
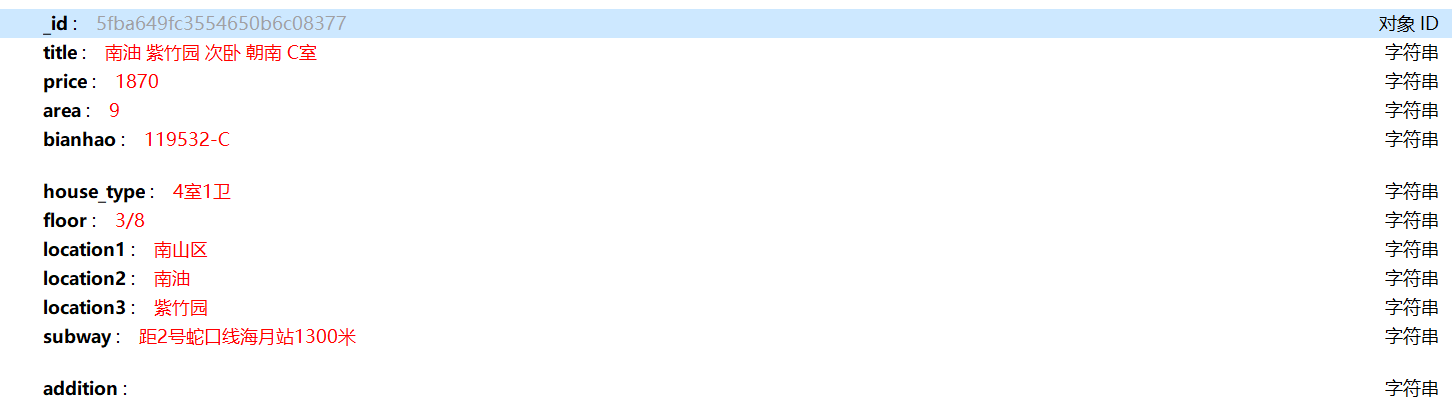
其中单条信息:
利用requestes\pyquery\BeautifulSoup爬取某租房公寓(深圳市)4755条租房信息及总结的更多相关文章
- PYTHON 爬虫笔记九:利用Ajax+正则表达式+BeautifulSoup爬取今日头条街拍图集(实战项目二)
利用Ajax+正则表达式+BeautifulSoup爬取今日头条街拍图集 目标站点分析 今日头条这类的网站制作,从数据形式,CSS样式都是通过数据接口的样式来决定的,所以它的抓取方法和其他网页的抓取方 ...
- python爬虫:利用BeautifulSoup爬取链家深圳二手房首页的详细信息
1.问题描述: 爬取链家深圳二手房的详细信息,并将爬取的数据存储到Excel表 2.思路分析: 发送请求--获取数据--解析数据--存储数据 1.目标网址:https://sz.lianjia.com ...
- 利用requests和BeautifulSoup爬取菜鸟教程的代码与图片并保存为markdown格式
还是设计模式的开卷考试,我想要多准备一点资料,于是写了个爬虫爬取代码与图片,有巧妙地进行格式化进一步处理,最终变为了markdown的格式 import requests from bs4 impor ...
- Python爬虫之利用BeautifulSoup爬取豆瓣小说(三)——将小说信息写入文件
#-*-coding:utf-8-*- import urllib2 from bs4 import BeautifulSoup class dbxs: def __init__(self): sel ...
- 如何利用Python网络爬虫爬取微信朋友圈动态--附代码(下)
前天给大家分享了如何利用Python网络爬虫爬取微信朋友圈数据的上篇(理论篇),今天给大家分享一下代码实现(实战篇),接着上篇往下继续深入. 一.代码实现 1.修改Scrapy项目中的items.py ...
- 利用Python网络爬虫爬取学校官网十条标题
利用Python网络爬虫爬取学校官网十条标题 案例代码: # __author : "J" # date : 2018-03-06 # 导入需要用到的库文件 import urll ...
- # [爬虫Demo] pyquery+csv爬取猫眼电影top100
目录 [爬虫Demo] pyquery+csv爬取猫眼电影top100 站点分析 代码君 [爬虫Demo] pyquery+csv爬取猫眼电影top100 站点分析 https://maoyan.co ...
- Python使用urllib,urllib3,requests库+beautifulsoup爬取网页
Python使用urllib/urllib3/requests库+beautifulsoup爬取网页 urllib urllib3 requests 笔者在爬取时遇到的问题 1.结果不全 2.'抓取失 ...
- python爬虫:爬取链家深圳全部二手房的详细信息
1.问题描述: 爬取链家深圳全部二手房的详细信息,并将爬取的数据存储到CSV文件中 2.思路分析: (1)目标网址:https://sz.lianjia.com/ershoufang/ (2)代码结构 ...
随机推荐
- STM32时钟和定时器
时钟源 STM32包含了5个时钟源,分别为HSI.HSE.LSI.LSE.PLL. HSI是高速内部时钟.RC振荡器,频率为8MHz: HSE是高速外部时钟,即晶振,可接石英/陶瓷谐振器或接外部时钟源 ...
- ERP仓库管理的操作与设计--开源软件诞生20
赤龙ERP库房管理讲解--第20篇 用日志记录"开源软件"的诞生 [点亮星标]----祈盼着一个鼓励 博主开源地址: 码云:https://gitee.com/redragon/r ...
- 出Bug表-假如诸葛亮是程序员(1024程序员节日献礼)
1 前言 欢迎访问南瓜慢说 www.pkslow.com获取更多精彩文章! 出Bug表 南瓜言:先司创业未半而中道破产,今培训造才,网课套钱,此诚百家争鸣之时也.然优秀骨干组队离职,新招小白乐于摸鱼者 ...
- maven 是什么
- 判断app访问还是web访问网站
function IsPC() { var userAgentInfo = navigator.userAgent; var Agents = ["Android", " ...
- linux系统软件启动sh脚本
在系统维护中,编写脚本会帮助运维提高效率,现记录一个通用的软件启动脚本.脚本内容如下: #!/bin/bash # 软件启动程序包名称 APP_NAME=datadog-4.2.0.jar # 软件名 ...
- LoadRunner接口脚本web_submit_data编写过程中遇到的问题及分享
工作中需要接口测试,报文编辑器一条条手工发费时费力,因此考虑利用web_submit_data函数POST方法进行报文编辑.在报文编辑中主要遇到了三个问题,其中一个问题耗时两天查到问题所在,在这里与大 ...
- k8s部署之系统初始化(一)
初始化 1.安装依赖包 yum -y install tree lrzsz nmap nc telnet vim wget lsof network-tools bash-completion bas ...
- php socket通信的简单实现
socket通信的原理在这里就不说了,它的用途还是比较广泛的,我们可以使用socket来做一个API接口出来,也可以使用socket来实现两个程序之间的通信,我们来研究一下在php里面如何实现sock ...
- Centos7安装Gitlab11
一.基础介绍 1.简介 一个基于GIT的源码托管解决方案 基于rubyonrails开发 集成了nginx postgreSQL redis sidekiq等组件 2.安装要求 2g内存以上,有点占内 ...