
用Python爬取文章,并转PDF格式电子书
wkhtmltopdf [软件],这个是必学准备好的,不然这个案例是实现不出来的
获取文章内容代码 (https://jq.qq.com/?_wv=1027&k=QgGWqAVF)
发送请求, 对于url地址发送请求
解析数据, 提取内容
保存数据, 先保存成html文件
再把html文件转成PDF
代码实现 (https://jq.qq.com/?_wv=1027&k=QgGWqAVF)
请求数据
python学习交流群:660193417###

import requests  # 数据请求模块

url = f'https://blog.csdn.net/fei347795790/article/list/1'  # 确定请求网址

# headers 请求头, 主要用于伪装python, 防止程序被服务器识别出来

headers = {

    'user-agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/100.0.4896.88 Safari/537.36'

}

# 用requests模块里面get方式发送请求

response = requests.get(url=url, headers=headers)

print(response.text)
<Response [200]> 响应对象 200 表示请求成功
解析数据, 提取内容 (https://jq.qq.com/?_wv=1027&k=QgGWqAVF)
python学习交流群:660193417###

for index in href:

    html_data = requests.get(url=index, headers=headers).text

    selector_1 = parsel.Selector(html_data)

    title = selector_1.css('#articleContentId::text').get()

    content = selector_1.css('#content_views').get()

    article_content = html_str.format(article=content)

    print(title)

    print(article_content)

    break
保存数据 (https://jq.qq.com/?_wv=1027&k=QgGWqAVF)
python学习交流群:660193417###

html_path = 'html\\' + title +'.html'

with open(html_path, mode='w', encoding=' utf-8') as f:

    f.write(article_content)

print(title,'保存成功')
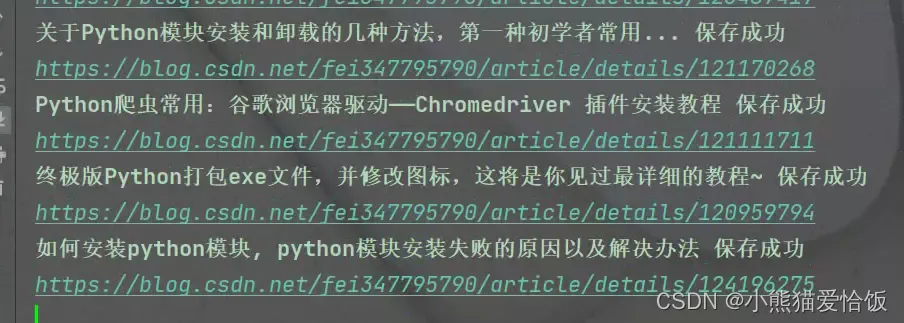
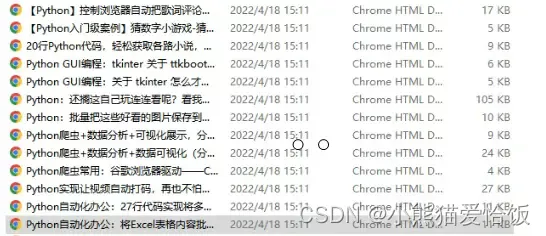
转制为pdf文件 (https://jq.qq.com/?_wv=1027&k=QgGWqAVF)
    html_path = 'html\\ + title + '.html'

    pdf_path = 'pdf\\' + title + '.pdf'

    with open(html_path, mode='w', encoding='utf-8') as f:

        f.write(article_content)

    config = pdfkit.configuration(wkhtmltopdf=r'C:\01-Software-installation\wkhtmltopdf\bin\wkhtmltopdf.exe')

    ppdfkit.from_file(html_path,pdf_path,configuration=config)

    print(title,'保存成功')
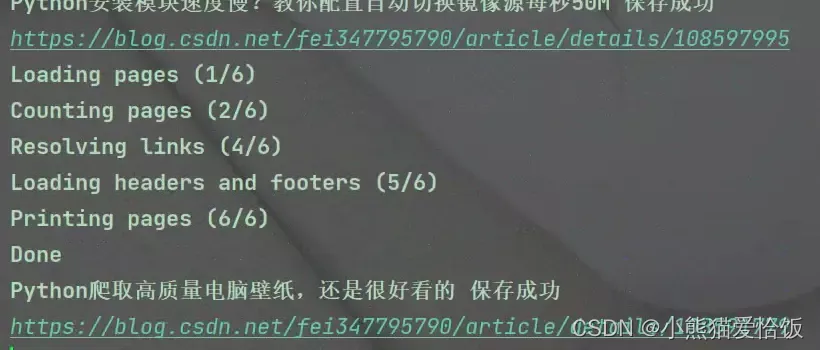
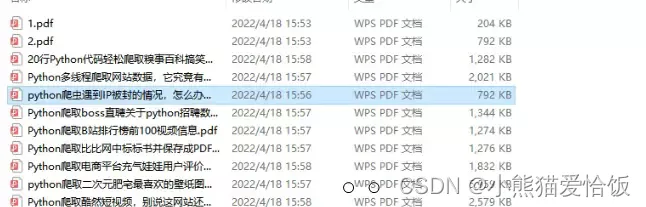
来!试试看!
用Python爬取文章,并转PDF格式电子书的更多相关文章
- python 爬取文章
这里我们利用强大的python爬虫来爬取一篇文章.仅仅做一个示范,更高级的用法还要大家自己实践. 好了,这里就不啰嗦了,找到一篇文章的url地址:http://www.duanwenxue.com/a ...
- 假期学习【十一】Python爬取百度词条写入csv格式 python 2020.2.10
今天主要完成了根据爬取的txt文档,从百度分类从信息科学类爬取百度词条信息,并写入CSV格式文件. txt格式文件如图: 为自己爬取内容分词后的结果. 代码如下: import requests fr ...
- 用Python抓取漫画并制作mobi格式电子书
想看某一部漫画,但是用手机看感觉屏幕太小,用电脑看吧有太不方面.正好有一部Kindle,决定写一个爬虫把漫画爬取下来,然后制作成 mobi 格式的电子书放到kindle里面看. 一.编写爬虫程序 用C ...
- python 爬取文章后存储excel 以及csv
import requests from bs4 import BeautifulSoup import random import openpyxl xls=openpyxl.Workbook() ...
- python爬取博客圆首页文章链接+标题
新人一枚,初来乍到,请多关照 来到博客园,不知道写点啥,那就去瞄一瞄大家都在干什么好了. 使用python 爬取博客园首页文章链接和标题. 首先当然是环境了,爬虫在window10系统下,python ...
- python爬取网站数据
开学前接了一个任务,内容是从网上爬取特定属性的数据.正好之前学了python,练练手. 编码问题 因为涉及到中文,所以必然地涉及到了编码的问题,这一次借这个机会算是彻底搞清楚了. 问题要从文字的编码讲 ...
- 没有内涵段子可以刷了,利用Python爬取段友之家贴吧图片和小视频(含源码)
由于最新的视频整顿风波,内涵段子APP被迫关闭,广大段友无家可归,但是最近发现了一个"段友"的app,版本更新也挺快,正在号召广大段友回家,如下图,有兴趣的可以下载看看(ps:我不 ...
- python爬取微信公众号
爬取策略 1.需要安装python selenium模块包,通过selenium中的webdriver驱动浏览器获取Cookie的方法.来达到登录的效果 pip3 install selenium c ...
- 萌新学习Python爬取B站弹幕+R语言分词demo说明
代码地址如下:http://www.demodashi.com/demo/11578.html 一.写在前面 之前在简书首页看到了Python爬虫的介绍,于是就想着爬取B站弹幕并绘制词云,因此有了这样 ...
随机推荐
- HCIE笔记-第三节-数据链路层与MAC地址
如果数据进行封装时,基于E2或者802.3标准,此时我们称之为是一个以太网数据帧. E2和802.3作用:定义帧头和帧尾的格式. 以太网是现在局域网组网的唯一标准. 数据:对于下层的每个层级而言,上层 ...
- 001_iBase4J学习之环境搭建
目录 序言 正文 第一关.拉取项目 第二关.导入数据库 第三关.修改 JDBC 配置文件 第四关.环境搭建,修改 nginx 设置 第五关.添加地址白名单 尾声 序言 大家好,我是白墨! 本次的目标是 ...
- 用 DOM 获取页面的元素方法集合
document.getElementById('id名') // 获取页面设置指定 id 的元素 document.getElementsByTagName('标签名') ...
- 1. 初识 JavaScript
1.1 JavaScript 是什么 布兰登·艾奇(Brendan Eich,1961年-). 神奇的大哥用10天完成 JavaScript 设计. 最初命名为 LiveScript,后来在与 Sun ...
- Electron 从零创建一个 Windows/OS X/Linux 的桌面可执行程序
[外链图片转存失败(img-3RucrgcX-1562556984462)(http://7vzsvy.com1.z0.glb.clouddn.com/electron-1-2.png "E ...
- Python爬虫__微博某个话题的内容数据
1 # -*- coding: utf-8 -*- 2 # @Time : 2020/8/18 15:39 3 # @Author : Chunfang 4 # @Email : 3470959534 ...
- 一种O(n)时间复杂度的计数排序算法和Top N热词算法
排序算法是研究非常广泛且超级经典的算法,主流排序算法的时间复杂度基本都在O(nlogn). 今天就介绍一种以hash表为基础的,时间复杂度能够达到O(n)的排序算法--计数排序: 同时基于它的思想,完 ...
- STS快捷键
在类或者方法上方加注释:shift+alt+J
- HashMap中红黑树插入节点的调整过程
如果有对红黑树的定义及调整过程有过研究,其实很容易理解HashMap中的红黑树插入节点的调整过程. "红黑树定义及调整过程"的参考文章:<红黑树原理.查找效率.插入及变化规则 ...
- 快速创建简单的mybatis应用
1.导包(配置pom.xml) 一定要用这个网站:https://mvnrepository.com/ 点击查看代码 <dependency> <groupId>org.myb ...