
机器学习-kmeans的使用
import numpy as np

import pandas as pd

import matplotlib

from matplotlib import pyplot as plt

%matplotlib inline

matplotlib.rcParams['font.sans-serif'] = ['SimHei']

data = pd.read_csv('./010-data_multivar.csv',header=None)

#拆分数据

dataset_X,dataset_y = data.iloc[:,:-],data.iloc[:,-]

# print(dataset_X.head())

dataset_X = dataset_X.values

dataset_y = dataset_y.values
无标签数据集可视化,将第一列feature作为X,第二列feature作为y
def visual_2D_dataset_dist(dataset):

    '''将二维数据集dataset显示在散点图中'''

    assert dataset.shape[]==,'only support dataset with 2 features'

    plt.figure()

    X=dataset[:,]

    Y=dataset[:,]

    plt.scatter(X,Y,marker='v',c='g',label='dataset')

    X_min,X_max=np.min(X)-,np.max(X)+

    Y_min,Y_max=np.min(Y)-,np.max(Y)+

    plt.title('dataset distribution')

    plt.xlim(X_min,X_max)

    plt.ylim(Y_min,Y_max)

    plt.xlabel('feature_0')

    plt.ylabel('feature_1')

    plt.legend()

visual_2D_dataset_dist(dataset_X)

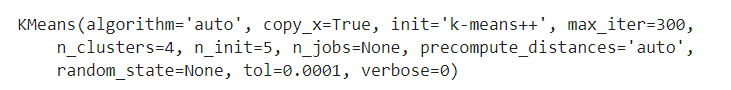
构造 kmeans
from sklearn.cluster import KMeans

#init

kmeans = KMeans(init='k-means++',n_clusters=4,n_init=5)

kmeans.fit(dataset_X)
将dataset_X聚类效果可视化
def visual_kmeans_effect(k_means,dataset):

    assert dataset.shape[1]==2,'only support dataset with 2 features'

    X=dataset[:,0]

    Y=dataset[:,1]

    X_min,X_max=np.min(X)-1,np.max(X)+1

    Y_min,Y_max=np.min(Y)-1,np.max(Y)+1

    # meshgrid 生成网格点坐标矩阵

    X_values,Y_values=np.meshgrid(np.arange(X_min,X_max,0.01),

                                  np.arange(Y_min,Y_max,0.01))

    # 预测网格点的标记

    predict_labels=k_means.predict(np.c_[X_values.ravel(),Y_values.ravel()])

    predict_labels=predict_labels.reshape(X_values.shape)

    plt.figure()

    plt.imshow(predict_labels,interpolation='nearest',

               extent=(X_values.min(),X_values.max(),

                       Y_values.min(),Y_values.max()),

               cmap=plt.cm.Paired,

               aspect='auto',

               origin='lower')

    # 将数据集绘制到图表中

    plt.scatter(X,Y,marker='v',facecolors='none',edgecolors='k',s=30)

    # 将中心点绘制到图中

    centroids=k_means.cluster_centers_

    plt.scatter(centroids[:,0],centroids[:,1],marker='o',

                s=100,linewidths=2,color='k',zorder=5,facecolors='b')

    plt.title('K-Means effect graph')

    plt.xlim(X_min,X_max)

    plt.ylim(Y_min,Y_max)

    plt.xlabel('feature_0')

    plt.ylabel('feature_1')

    plt.show()

visual_kmeans_effect(kmeans,dataset_X)

# 鸢尾花聚类
from sklearn.datasets import load_iris

datairis = load_iris()

dataset = datairis.data

from sklearn.cluster import KMeans

#init

kmeans = KMeans(init='k-means++',n_clusters=,n_init=)

kmeans.fit(dataset)

print(kmeans.labels_) #去除标签

print(datairis)

机器学习-kmeans的使用的更多相关文章
- 视觉机器学习------K-means算法
K-means(K均值)是基于数据划分的无监督聚类算法. 一.基本原理 聚类算法可以理解为无监督的分类方法,即样本集预先不知所属类别或标签,需要根据样本之间的距离或相似程度自动进行分类.聚 ...
- 机器学习——KMeans聚类,KMeans原理,参数详解
0.聚类 聚类就是对大量的未知标注的数据集,按数据的内在相似性将数据集划分为多个类别,使类别内的数据相似度较大而类别间的数据相似度较小,聚类属于无监督的学习方法. 1.内在相似性的度量 聚类是根据数据 ...
- 机器学习——KMeans
导入类库 from sklearn.cluster import KMeans from sklearn.datasets import make_blobs import numpy as np i ...
- 机器学习--k-means聚类原理
“物以类聚,人以群分”, 所谓聚类就是将相似的元素分到一"类"(有时也被称为"簇"或"集合"), 簇内元素相似程度高, 簇间元素相似程度低. ...
- Python之机器学习K-means算法实现
一.前言: 今天在宿舍弄了一个下午的代码,总算还好,把这个东西算是熟悉了,还不算是力竭,只算是知道了怎么回事.今天就给大家分享一下我的代码.代码可以运行,运行的Python环境是Python3.6以上 ...
- 机器学习K-Means
1.K-Means聚类算法属于无监督学习算法. 2.原理:先随机选择K个质心,根据样本到质心的距离将样本分配到最近的簇中,然后根据簇中的样本更新质心,再次计算距离重新分配簇,直到质心不再发生变化,迭代 ...
- 09-赵志勇机器学习-k-means
(草稿) k-means: 1. 随机选取n个中心 2. 计算每个点到各个中心的距离 3. 距离小于阈值的归成一类. 4. 计算新类的质心,作为下一次循环的n个中心 5. 直到新类的质心和对应本次循环 ...
- 机器学习-K-means聚类及算法实现(基于R语言)
K-means聚类 将n个观测点,按一定标准(数据点的相似度),划归到k个聚类(用户划分.产品类别划分等)中. 重要概念:质心 K-means聚类要求的变量是数值变量,方便计算距离. 算法实现 R语言 ...
- 机器学习 - k-means聚类
k-means简介 k-means是无监督学习下的一种聚类算法,简单说就是不需要数据标签,仅靠特征值就可以将数据分为指定的几类.k-means算法的核心就是通过计算每个数据点与k个质心(或重心)之间的 ...
随机推荐
- Recovering Low-Rank Matrices From Few Coefficients In Any Basis
目录 引 主要结果 定理2,3 定理4 直观解释 Recovering Low-Rank Matrices From Few Coefficients In Any Basis-David Gross ...
- ABP实践(2)-ASP.NET Core 2.x版本EntityFrameworkCore(EF)使用mysql数据库
上一篇中EntityFrameworkCore默认使用的是微软的sql server,本篇改为mysql步骤如下: 1,在基础层xxx.EntityFrameworkCore依赖项添加Pomelo.E ...
- LR socket协议脚本
socket协议分为TCP.UDP两种(区别与联系在此不做赘述),一种为长连接.一种为短连接.如果创建连接时在init中对应关闭连接在end中,则为长连接:如果创建关闭连接都是在action则为短连接 ...
- SSM项目整合Quartz
一.背景 SSM项目中要用到定时器,初期使用Timer,后来用spring 的schedule,都比较简单,所以功能比较单一而且他们不能动态的配置时间.后来就研究quartz,准备整合到项目中.Qua ...
- Python网络爬虫精要
目的 学习如何从互联网上获取数据.数据科学必须掌握的技能之一. 本文所用到的第三方库如下: requests, parsel, selenium requests负责向网页发送HTTP请求并得到响应, ...
- 深入Redis持久化
转载:https://segmentfault.com/a/1190000017193732 一.Redis高可用概述 在介绍Redis高可用之前,先说明一下在Redis的语境中高可用的含义. 我们知 ...
- servlet(4)异常处理
一.异常处理 当一个 Servlet 抛出一个异常时,处理异常的servlet可以从HttpServletRequest里面得到几个属性,如下: 1.javax.servlet.error.statu ...
- sql中检查时间是否重叠
先画一个时间轴,方便理解. 设新的时间块,开始时间为@BeginDate,结束时间为@EndDate.数据库中的数据为BeginDate和EndDate 这样可以直观的看出来,新的时间块插入进来,只需 ...
- codeforces675D
Tree Construction CodeForces - 675D During the programming classes Vasya was assigned a difficult pr ...
- 代理与hook
参考:Java 动态代理 代理是什么 为什么需要代理呢?其实这个代理与日常生活中的“代理”,“中介”差不多:比如你想海淘买东西,总不可能亲自飞到国外去购物吧,这时候我们使用第三方海淘服务比如惠惠购物助 ...