
Spark MLlib KMeans 聚类算法
一.简介
KMeans 算法的基本思想是初始随机给定K个簇中心,按照最邻近原则把分类样本点分到各个簇。然后按平均法重新计算各个簇的质心,从而确定新的簇心。一直迭代,直到簇心的移动距离小于某个给定的值。
二.步骤
1.为待聚类的点寻找聚类中心。
2.计算每个点到聚类中心的距离,将每个点聚类到该点最近的聚类中。
3.计算每个聚类中所有点的坐标平均值,并将这个平均值作为新的聚类中心。
4.反复执行步骤2,3,直到聚类中心不再进行大范围移动或者聚类迭代次数达到要求为止。
三.演示
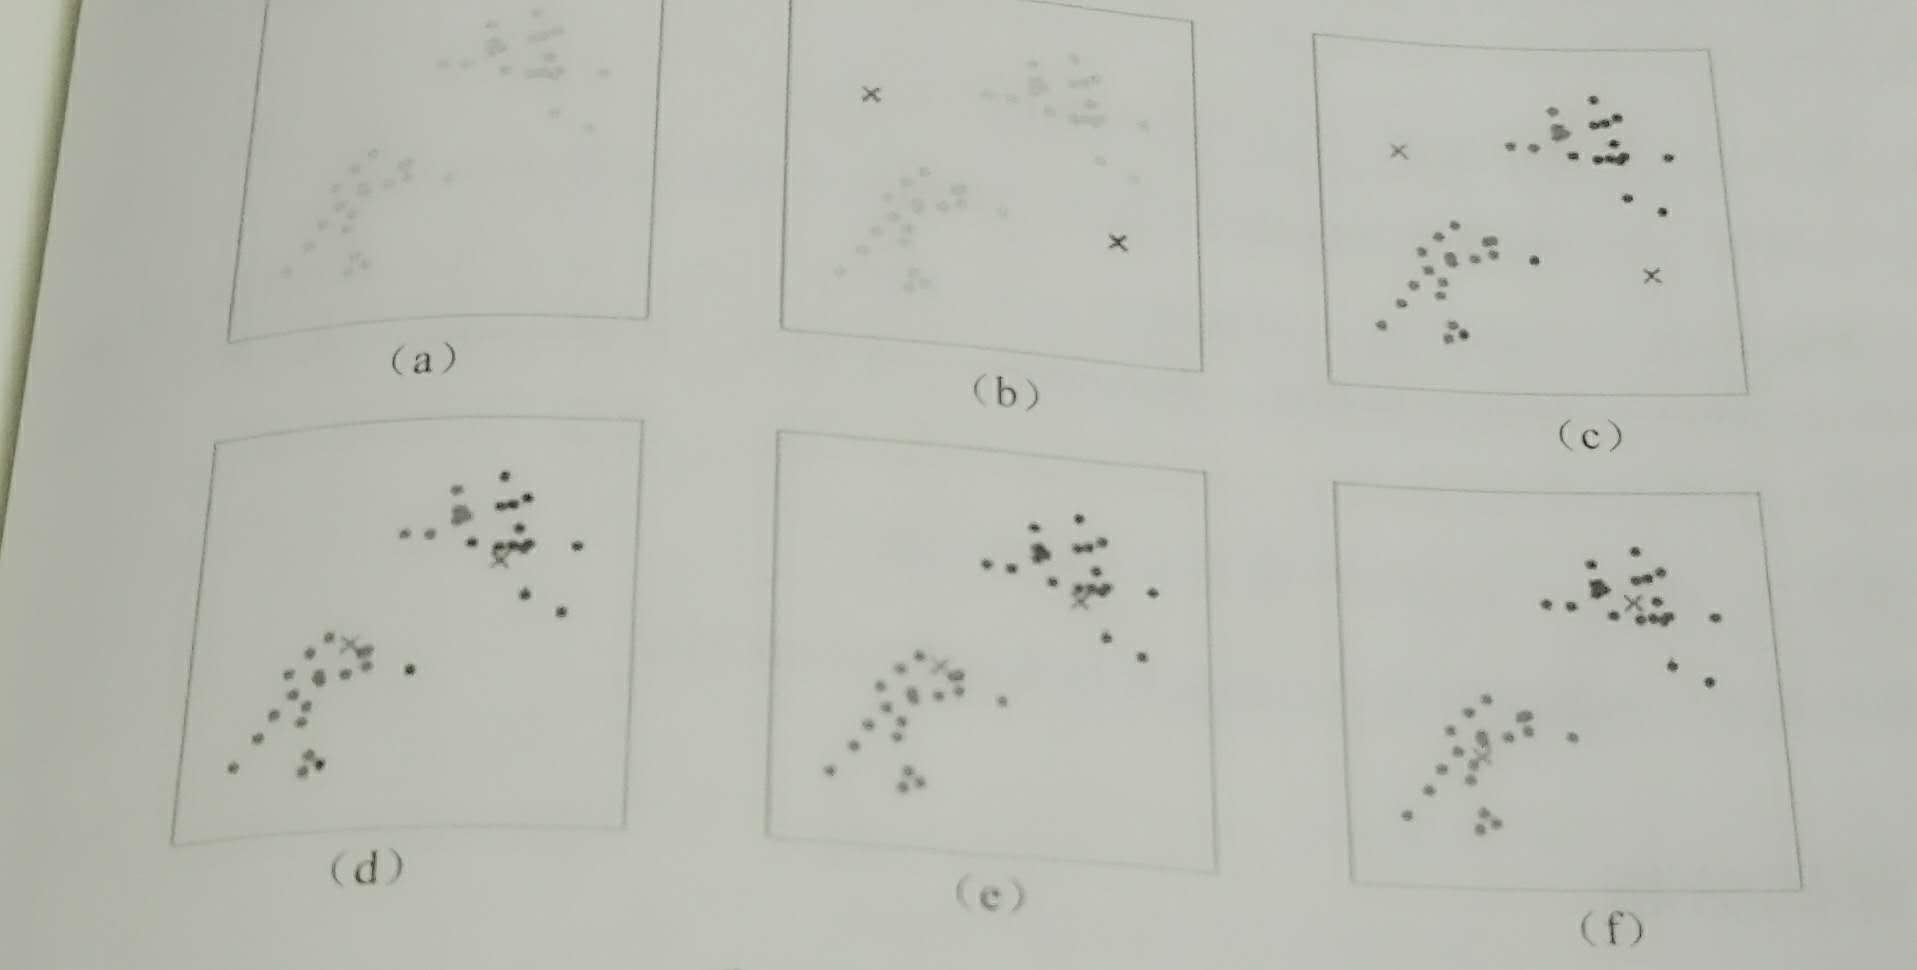
四.初始中心点选择
1.随机选择k个点作为中心点。
对应算法:KMeans
2.采用k-means++选择中心点。
基本思想:初始的聚类中心点之间的相互距离要尽可能远。
步骤:
1.从输入的数据点集合中随机选择一个点作为第一个聚类中心点。
2.对于数据点中的每一个点【已选择为中心点的除外】x,计算它与最近聚类中心点的距离D(x)。
3.选择一个新的数据点为聚类的中心点,原则是D(x)较大的点,被选择的概率较大。
4.重复步骤2,3,直到所有的聚类中心点被选择出来。
5.使用这k个初始中心点运行标准的KMeans算法。
五.D(x)映射被选择的概率
1.从输入的数据点集合D中随机选择一个点作为第一个聚类中心点。
2.对于数据点中的每一个点【已选择为中心点的除外】x,计算它与最近聚类中心点的距离Si,对所有Si求和得到sum。
3.取一个随机数,用权重的方式计算下一个中心点。取随机值random(0<random<sum),对点集D循环,做random-=Si运算,直到random<0,那么点i就是下一个中心点。
六.源码分析
1.MLlib的KMeans聚类模型的runs参数可以设置并行计算聚类中心的数量,runs代表同时计算多组聚类中心点,最后去计算结果最好的那一组中心点作为聚类的中心点。
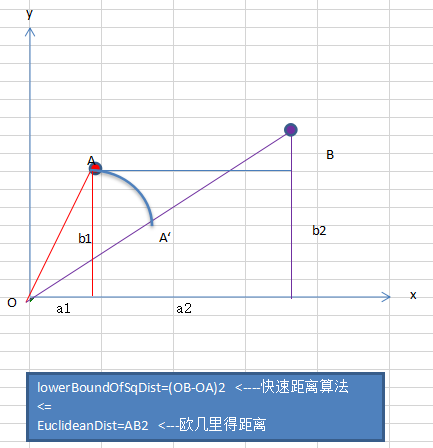
2.KMeans快速查找,计算距离

七.代码测试
1.测试数据
0.0 0.0 0.0
0.1 0.1 0.1
0.2 0.2 0.2
9.0 9.0 9.0
9.1 9.1 9.1
9.2 9.2 9.2
4.5 5.6 4.3
2.代码实现
package big.data.analyse.mllib

import org.apache.log4j.{Level, Logger}

import org.apache.spark.{SparkConf, SparkContext}

import org.apache.spark.mllib.clustering.{KMeans, KMeansModel}

import org.apache.spark.mllib.linalg.Vectors

/**

  * Created by zhen on 2019/4/11.

  */

object KMeansTest {

  Logger.getLogger("org").setLevel(Level.WARN)

  def main(args: Array[String]) {

    val conf = new SparkConf().setAppName("KMeansExample")

    conf.setMaster("local[2]")

    val sc = new SparkContext(conf)

    // Load and parse the data

    val data = sc.textFile("data/mllib/kmeans_data.txt")

    val parsedData = data.map(s => Vectors.dense(s.split(' ').map(_.toDouble))).cache()

    // split data to train data and test data

    val weights = Array(0.8, 0.2)

    val splitParseData = parsedData.randomSplit(weights)

    // Cluster the data into two classes using KMeans

    val numClusters = 2

    val numIterations = 20

    val clusters = KMeans.train(parsedData, numClusters, numIterations)

    // Evaluate clustering by computing Within Set Sum of Squared Errors

    val WSSSE = clusters.computeCost(parsedData)

    println("Within Set Sum of Squared Errors = " + WSSSE)

    // predict data

    val result = clusters.predict(parsedData)

    result.foreach(println(_))

    // Save and load model

    clusters.save(sc, "target/KMeansModel")

    val sameModel = KMeansModel.load(sc, "target/KMeansModel")

    sc.stop()

  }

}
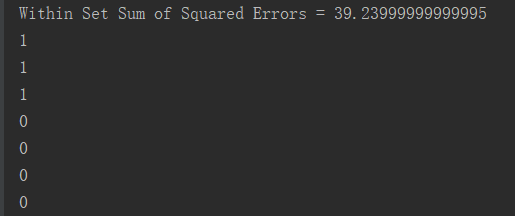
3.结果
八.总结
聚类作为无监督的机器学习算法,只能根据具体的算法实现对不同数据进行分类,不能具体指出类内不同数据的相似性,以及与其它类内节点的差异性。
Spark MLlib KMeans 聚类算法的更多相关文章
- Spark MLBase分布式机器学习系统入门:以MLlib实现Kmeans聚类算法
1.什么是MLBaseMLBase是Spark生态圈的一部分,专注于机器学习,包含三个组件:MLlib.MLI.ML Optimizer. ML Optimizer: This layer aims ...
- K-Means 聚类算法
K-Means 概念定义: K-Means 是一种基于距离的排他的聚类划分方法. 上面的 K-Means 描述中包含了几个概念: 聚类(Clustering):K-Means 是一种聚类分析(Clus ...
- k-means聚类算法python实现
K-means聚类算法 算法优缺点: 优点:容易实现缺点:可能收敛到局部最小值,在大规模数据集上收敛较慢使用数据类型:数值型数据 算法思想 k-means算法实际上就是通过计算不同样本间的距离来判断他 ...
- K-Means 聚类算法原理分析与代码实现
前言 在前面的文章中,涉及到的机器学习算法均为监督学习算法. 所谓监督学习,就是有训练过程的学习.再确切点,就是有 "分类标签集" 的学习. 现在开始,将进入到非监督学习领域.从经 ...
- Kmeans聚类算法原理与实现
Kmeans聚类算法 1 Kmeans聚类算法的基本原理 K-means算法是最为经典的基于划分的聚类方法,是十大经典数据挖掘算法之一.K-means算法的基本思想是:以空间中k个点为中心进行聚类,对 ...
- 机器学习六--K-means聚类算法
机器学习六--K-means聚类算法 想想常见的分类算法有决策树.Logistic回归.SVM.贝叶斯等.分类作为一种监督学习方法,要求必须事先明确知道各个类别的信息,并且断言所有待分类项都有一个类别 ...
- 转载: scikit-learn学习之K-means聚类算法与 Mini Batch K-Means算法
版权声明:<—— 本文为作者呕心沥血打造,若要转载,请注明出处@http://blog.csdn.net/gamer_gyt <—— 目录(?)[+] ================== ...
- 沙湖王 | 用Scipy实现K-means聚类算法
沙湖王 | 用Scipy实现K-means聚类算法 用Scipy实现K-means聚类算法
- Matlab中K-means聚类算法的使用(K-均值聚类)
K-means聚类算法采用的是将N*P的矩阵X划分为K个类,使得类内对象之间的距离最大,而类之间的距离最小. 使用方法:Idx=Kmeans(X,K)[Idx,C]=Kmeans(X,K) [Idx, ...
随机推荐
- .NET(WinCE、WM)转Android开发——Xamarin和Smobiler对比
对比 WinCE Android 行业场景 扫描分拣.车载.工控 扫描分拣.车载定位 开发语言 C++.C# Java/.NET(Smobiler) 开发环境 Visual Studio Androi ...
- js 原型,原型链,原型链继承浅析
对于网上的关于原型,原型链和原型链继承的晦涩语言说明就不累赘了,复制粘贴过来再解释一遍怕自己也整蒙了,本人最怕空气突然安静,四目对视,大眼对小眼,一脸懵逼. 我们先看下面
- 如何通过免费开源ERP Odoo建立你的团队, 销售过程和目标
这种快速的一步一步的指南将引导您完成Odoo CRM, 帮助您轻松处理您的销售渠道, 时刻从线索到客户管理您的销售渠道. 配置 从 Odoo初始化后,生成你的数据库, 选择CRM 作为第一个app安装 ...
- alter session set current_schema=Schema
使用CURRENT_SCHEMA之后,当前会话所参考的默认SCHEMA变为设置的用户,而不再是当前的用户:其实需要稍微理解一下user和schema的区别先:user即oracle中的用户,和所有系统 ...
- Centos 7 django环境搭建
1.本机网卡配置信息如下: vim /etc/sysconfig/network-scripts/ifcfg-ens33 TYPE=Ethernet PROXY_METHOD=none BROWSER ...
- Windows Server 2016-命令行批量导出AD用户列表信息
本章节为大家带来如何通过Powershell或ldifde命令行方式导出域用户列表信息,方便大家日常运维工作中使用. Powershell方式导出现有Staff目录下所有用户信息列表: Get-ADU ...
- python+selenium 自动化测试实战
一.前言: 之前的文章说过, 要写一篇自动化实战的文章, 这段时间比较忙再加回家过11一直没有更新博客,今天整理一下实战项目的代码共大家学习.(注:项目是针对我们公司内部系统的测试,只能内部网络访问, ...
- Linux知识要点大全(第二章)
第二章 linux操作系统安装与配置主要内容 1:vmware虚拟机安装与使用 2:Linux系统安装前准备 3:Linux Centos 系统的安装 4:Centos 6.8的登录和关闭 5:C ...
- .NET Core微服务之基于Steeltoe使用Hystrix熔断保护与监控
Tip: 此篇已加入.NET Core微服务基础系列文章索引 => Steeltoe目录快速导航: 1. 基于Steeltoe使用Spring Cloud Eureka 2. 基于Steelt ...
- 如何开发AR增强现实应用与产品
2016年被称为VR元年,可见火爆程度,但是我要告诉你,其实还有一种技术AR(增强现实)技术,才是下一个真正的“风口”技术.可以预见的是,未来AR应用爆发之时,必将超越VR产业规模,开拓千亿级市场空间 ...