
二十五、Hadoop学记笔记————Hive复习与深入
Hive主要为了简化MapReduce流程,使非编程人员也能进行数据的梳理,即直接使用sql语句代替MapReduce程序
Hive建表的时候元数据(表明,字段信息等)存于关系型数据库中,数据存于HDFS中。
此元数据与HDFS中的元数据需要区分清楚,HDFS中元数据(文件名,文件长度等)存于Namenode中,数据存于Datanode中。
本次使用的是hive1.2.2版本
下载完毕之后解压:
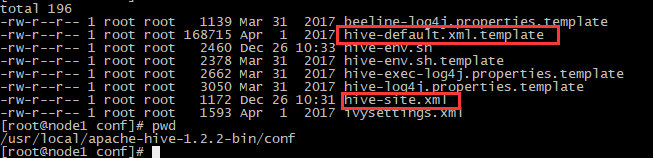
将default文件复制一份成site文件,然后打开site文件,清空其内容,然后配置如下参数:
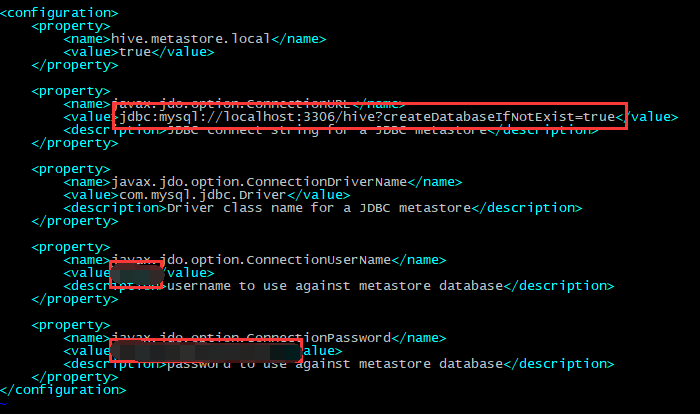
hive.metastore.local表示元数据存于本地
其中jdbc的hive是mysql中,提供给hive的database的名称,可自行修改,后续是登录的账号和密码,可以使用root,也可以新建一个hive用户,本机采用的是新建一个hive用户。
之后将mysql的jdbc驱动放入hive的lib目录下:

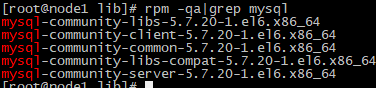
之后安装mysql,并在mysql下create名为hive的数据库,本机使用mysql5.7,数据库安装不做描述:
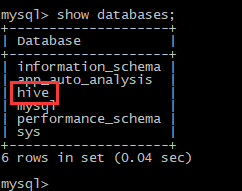
在hive中新建的表的表结构会在mysql中相应的databse内存储:
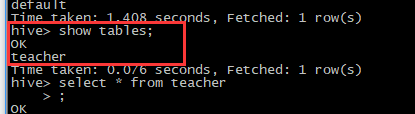

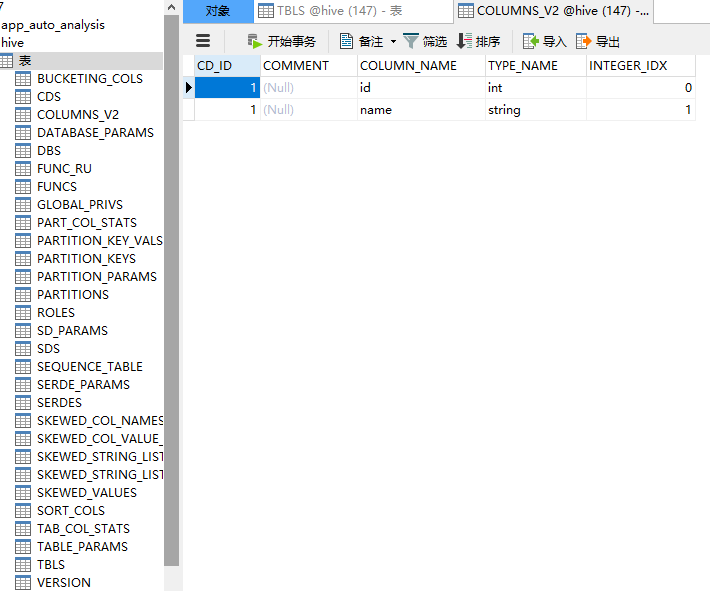
之后在例举一个复杂点的数据表,主要包含了数组型字段和map型字段,并且附带partition分区,例子来源于hive官网:
CREATE TABLE user_info(
id INT,
name STRING,
hobby ARRAY < STRING >,
goodatlol MAP < STRING, STRING >
)
PARTITIONED BY(dt STRING)
ROW FORMAT DELIMITED
FIELDS TERMINATED BY '\t'
COLLECTION ITEMS TERMINATED BY ','
MAP KEYS TERMINATED BY ':'
STORED AS TEXTFILE;
先新建一个user_info表:
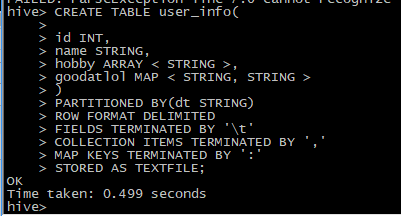
其中hobby为数组型字段,goodatlol为map型字段。fields的分隔符'\t'表示文件每一行的分隔符,collection的分隔符','表示数组型字段的分隔符,map的分隔符':'表示map字段的分隔符。
这时候在hdfs的该路径下回出现一个文件夹user_info:
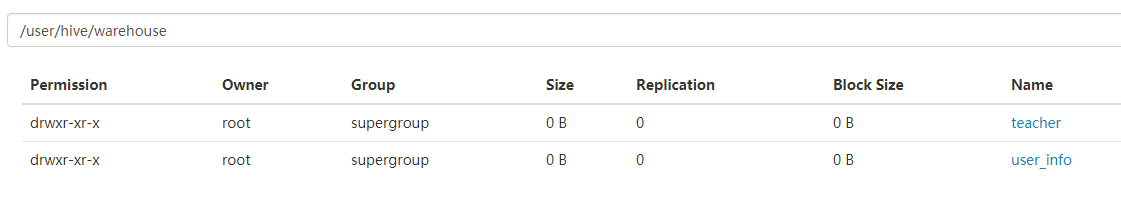
由此可见,hive中的数据表,表结构的元数据存在所连接的关系型数据库中,而数据信息存于hdfs。
之后录入信息,新建文件,名字不限,内容如下:

load data local inpath '/home/tyx/temp/userinfo' into table user_info;
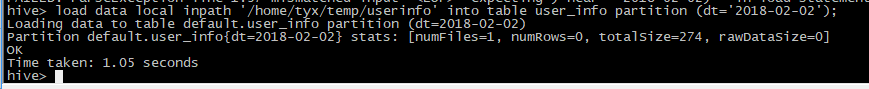
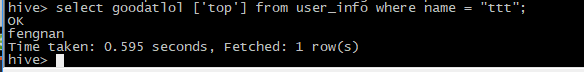
可用查询语句得出ttt同学喜欢上单风男:
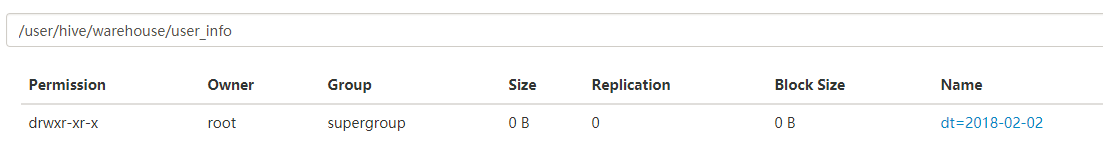
之后在hdfs的user_info路径下还会出现分区:
前面讲述的是建表和查询,现在说一个插入比较常用的方法,由于Hive是数据仓库,主要作用是用来存放、查询和统计数据,因此插入一般是直接覆盖,而不会像Mysql那样经常一条一条的插入。在Hive中,Insert into默认是关闭的,需要做一些配置才能开启,感兴趣的朋友可以自行查询,此处只介绍insert overwrite方法,标准语法如下(源自官方文档):
INSERT OVERWRITE TABLE tablename1 [PARTITION (partcol1=val1, partcol2=val2 ...) [IF NOT EXISTS]] select_statement1 FROM from_statement;
意思就是从一个语句中读取所有数据并覆盖原数据。前面也提到Hive一般用来做统计查询,通常情况下统计所需要的字段可能分布在好几张数据表上。就算只存在于一张数据表,那统计所需要的字段也只有2到3个,新建一个表专门用来查询也可以提高查询效率。
新建一个user_test表:
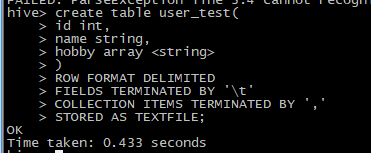
这个表相较于user_info表没有goodatlol字段和partition分区。
然后使用insert overwrite语句,将user_info中的id,name和hobby插入到user_test中来。
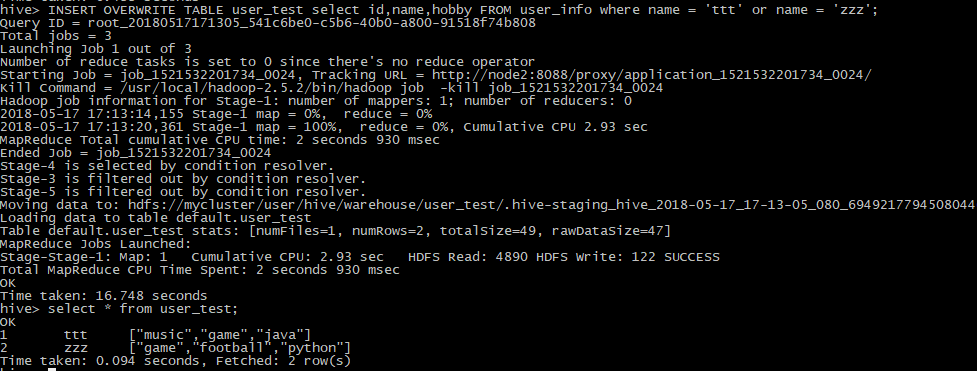
可以看到这时user_info中的name为ttt和zzz的数据都已经插入到了表user_info中,这时在该表中进行统计查询效率会比在user_info中快。
该语句在下面场景会非常实用,比如一个表A很很多字段,其中1号程序员需要用到A中的1、2、3字段做统计分析,程序员2号需要用到A中的3、6、8字段做统计分析,那么1号和2号分别都键自己的统计表会更加有效率
二十五、Hadoop学记笔记————Hive复习与深入的更多相关文章
- 二十、Hadoop学记笔记————Hive On Hbase
Hive架构图: 一般用户接口采用命令行操作, hive与hbase整合之后架构图: 使用场景 场景一:通过insert语句,将文件或者table中的内容加入到hive中,由于hive和hbase已经 ...
- 二十三、Hadoop学记笔记————Spark简介与计算模型
spark优势在于基于内存计算,速度很快,计算的中间结果也缓存在内存,同时spark也支持streaming流运算和sql运算 Mesos是资源管理框架,作为资源管理和任务调度,类似Hadoop中的Y ...
- 二十一、Hadoop学记笔记————kafka的初识
这些场景的共同点就是数据由上层框架产生,需要由下层框架计算,其中间层就需要有一个消息队列传输系统 Apache flume系统,用于日志收集 Apache storm系统,用于实时数据处理 Spark ...
- 二十四、Hadoop学记笔记————Spark的架构
master为主节点 一个集群中可能运行多个application,因此也可能会有多个driver DAG Scheduler就是讲RDD Graph拆分成一个个stage 一个Task对应一个Spa ...
- 二十二、Hadoop学记笔记————Kafka 基础实战 :消费者和生产者实例
kafka的客户端也支持其他语言,这里主要介绍python和java的实现,这两门语言比较主流和热门 图中有四个分区,每个图形对应一个consumer,任意一对一即可 获取topic的分区数,每个分区 ...
- 十九、Hadoop学记笔记————Hbase和MapReduce
概要: hadoop和hbase导入环境变量: 要运行Hbase中自带的MapReduce程序,需要运行如下指令,可在官网中找到: 如果遇到如下问题,则说明Hadoop的MapReduce没有权限访问 ...
- 十八、Hadoop学记笔记————Hbase架构
Hbase结构图: Client,Zookeeper,Hmaster和HRegionServer相互交互协调,各个组件作用如下: 这几个组件在实际使用过程中操作如下所示: Region定位,先读取zo ...
- 十七、Hadoop学记笔记————Hbase入门
简而言之,Hbase就是一个建立在Hdfs文件系统上的数据库(mysql,orecle等),不同的是Hbase是针对列的数据库 Hbase和普通的关系型数据库区别如下: Hbase有一些基本的术语,主 ...
- python3.4学习笔记(二十五) Python 调用mysql redis实例代码
python3.4学习笔记(二十五) Python 调用mysql redis实例代码 #coding: utf-8 __author__ = 'zdz8207' #python2.7 import ...
随机推荐
- 【Visual C++】游戏编程学习笔记之三:游戏循环的使用
本系列文章由@二货梦想家张程 所写,转载请注明出处. 本文章链接:http://blog.csdn.net/terence1212/article/details/44208419 作者:Zee ...
- CentOS 6.5安装MongoDB 2.6(多yum数据源)
下面我们在CentOS 6.5 x64系统上安装最新的MongoDB 2.6.5版. 在MongoDB v2.6.5版的软件仓库一共有五个包: 1)mongodb-org此包是元数据包,它可以实现自动 ...
- CUDA版本的OpenCL在windows 7的下编程初步
参考文献: http://blog.csdn.net/neoxmu/article/details/8866928 我安装的是CUDA5.5,代码如下: //#include "stdafx ...
- listview中的adapter学习小结
概述 Adapter是数据和UI之间的一个桥梁,在listview,gridview等控件中都会使用到,android给我们提拱了4个adapte供我们使用: BaseAdapter是一个抽象类,继承 ...
- Spring 学习笔记 ----依赖注入
依赖注入 有三种方式,本文只学习下属性注入. 属性注入 属性注入即通过 setXxx方法()注入Bean的属性值或依赖对象,由于属性注入方式具有可选择性和灵活性高的优点,因此属性注入方式是 ...
- int类型被强制转换成较低精度的byte类型
公司的项目上线之前会进行代码合规性检查,其中很容易违反的一个规则就是“不要把原始类型转换成较低的精度”,实际开发的过程中,很多方法在处理数据时,尤其在做移位操作的时候,难免要把int类型转换成byte ...
- iframe之局部刷新
例如: <iframe src="1.htm" name="ifrmname" id="ifrmid"></ifram ...
- jvm垃圾回收(三)
一.分代思想(年轻代.老年代.永久代): 1.一个新人(new对象)会优先在伊甸园(Eden区)出生,当伊甸园(Eden区)人口达到最大容量时,JVM会派MinorGC去看看哪些人还有价值 2.伊甸园 ...
- php添加日志文件
记录一下. 有时候写测试代码的时候,不习惯直接在屏幕上输出反馈,那么可以配置日志文件,把需要输出的内容追加到日志文件里面,就很方便. Php自带日志系统,可以参考网上的博客配置. 我要说的是,如果你的 ...
- oracle数据库语句积累
1.从一个表选出数据更新另一个表(后面的exists一定要加) update jqhdzt set shid = (select shid from v_plat_userjqinfo t where ...