
BeautifulSoup与aiohttp的简单应用-爬取《网上中华五千年》音频
香港电台的节目素质都比较不错,其中有个《中华五千年》的节目是以情景剧与旁白的形式来展示历史故事,由传说时代一直到民国,1983年首播至2000年,非常长寿的一个节目。网上能找到版本声音非常模糊,不过在其《网上中华五千年》的网站上可以在线收听所有节目。虽然可以在线听,但要science上网,而且在线听中断了就不能再续着听,很难受。因此,就想到利用Python来的爬虫来把节目都下载下来慢慢听。
分析Html页面
在浏览器打开审查元素找到音频的链接标签,发现链接都在class为.listen-button的a标签里。只要定位到这个标签,取出text作为文件名,href作为下载url就可以了。

代码实现
代码很简单,首先,主体结构是这样的:
'''

    下载中华五千年

'''

from bs4 import BeautifulSoup

import requests,urllib,re

import time

import aiohttp

import asyncio

import os

async def main():

    start_page = 1

    while True:

        url = 'http://rthk9.rthk.hk/chiculture/fivethousandyears/subpage{0}.htm'.format(start_page)

        soup = await getUrl(url)      #取html内容

        if not soup.title: return   #直到无内容退出

        title = soup.title.text

        title = title[title.rfind(' ')+1:]

        listenbutton = soup.select(".listen-button") #查出所有.listen-button类的标签

        #根据title 创建相应的文件夹

        rootPath = './中华五千年/'

        if not os.path.exists(rootPath + title):

            os.makedirs(rootPath + title)

        for l in listenbutton:

            if  l.text != "":

                href = l['href']

                filename  = str(title) +'_' + str(l.text)

                if filename.find('公元') > -1

                    await download(filename=filename,url=href,title=title)  #下载语音

        start_page += 1 #下一页

asyncio.run(main())
其中异步函数(协程)getUrl :
async def getUrl(url):

    async with aiohttp.ClientSession() as session:

        #因需science上网所以需要本地代理

        async with session.get(url,proxy='http://127.0.0.1:1080') as resp:

            wb_data = await resp.text()

            soup = BeautifulSoup(wb_data,'lxml')

    return soup
异步下载语音函数 download:
async def download(url,filename,title):

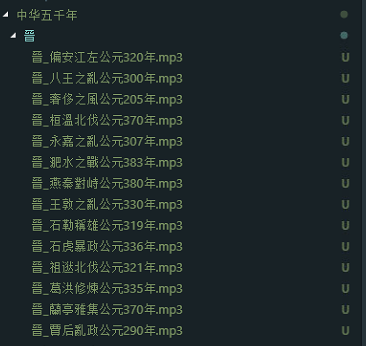
    file_name = './中华五千年/{0}/{1}'.format(title,filename + '.mp3')

    async with aiohttp.ClientSession() as session:

        async with session.get(url,proxy='http://127.0.0.1:1080') as resp:

            with open(file_name, 'wb') as fd:

                while True:

                    chunk = await resp.content.read()

                    if not chunk:

                        break

                    fd.write(chunk)
由于用了异步IO的方式,很快便可以下载完一页。
BeautifulSoup与aiohttp的简单应用-爬取《网上中华五千年》音频的更多相关文章
- Python超简单的爬取网站中图片
1.首先导入相关库 import requests import bs4 import threading #用于多线程爬虫,爬取速度快,可以完成多页爬取 import os 2.使用bs4获取htm ...
- 使用webmagic爬虫对百度百科进行简单的爬取
分析要爬取的网页源码: 1.打开要分析的网页,查看源代码,找到要爬取的内容: (选择网页里的一部分右击审查元素也行) 2.导入jar包,这个就直接去网上下吧: 3.写爬虫: package com.g ...
- web scraper——简单的爬取数据【二】
web scraper——安装[一] 在上文中我们已经安装好了web scraper现在我们来进行简单的爬取,就来爬取百度的实时热点吧. http://top.baidu.com/buzz?b=1&a ...
- Python爬取网上车市[http://www.cheshi.com/]的数据
#coding:utf8 #爬取网上车市[http://www.cheshi.com/]的数据 import requests, json, time, re, os, sys, time,urlli ...
- 【Python数据分析】简单爬虫 爬取知乎神回复
看知乎的时候发现了一个 “如何正确地吐槽” 收藏夹,里面的一些神回复实在很搞笑,但是一页一页地看又有点麻烦,而且每次都要打开网页,于是想如果全部爬下来到一个文件里面,是不是看起来很爽,并且随时可以看到 ...
- 12月4日学习爬虫007.使用Urllib模块进行简单网页爬取
笔记如下: 1.https是http加强版协议(安全协议)http(普通网络通信协议) 爬数据 如果爬https发现和理想中的数据不同,可以改为http 直接去掉s即可 2.使用Urllib爬取简单网 ...
- 【Python】简单实现爬取小说《天龙八部》,并在页面本地访问
背景 很多人说学习爬虫是提升自己的一个非常好的方法,所以有了第一次使用爬虫,水平有限,依葫芦画瓢,主要作为学习的记录. 思路 使用python的requests模块获取页面信息 通过re模块(正则表达 ...
- python简单爬虫爬取百度百科python词条网页
目标分析:目标:百度百科python词条相关词条网页 - 标题和简介 入口页:https://baike.baidu.com/item/Python/407313 URL格式: - 词条页面URL:/ ...
- Python爬虫之简单的爬取百度贴吧数据
首先要使用的第类库有 urllib下的request 以及urllib下的parse 以及 time包 random包 之后我们定义一个名叫BaiduSpider类用来爬取信息 属性有 url: ...
随机推荐
- robotframework自动化系列:登陆操作
robotframework自动化系统:登录 robotframework对于编程能力比较弱的测试人员而言,真的是雪中送炭!我们可以使用robotframework根据之前完成的测试用例,一步步完善自 ...
- Spring + MyBaits java.lang.reflect.InvocationTargetException 启动日志报错
调试发现 实例化 class org.apache.ibatis.logging.slf4j.Slf4jImpl时发生异常,所以 slf4j jar 问题解决: http://www.cnblogs. ...
- 基于Tcp协议的上传下载
目录格式: 构建此目录就可随意使用! client端 import socket import sys import os import json import struct sk = socket. ...
- windows下配置java环境jdk
Windows系统下搭建java的开发环境和配置环境变量 具体步骤打开链接地址:https://www.cnblogs.com/lijuntao/p/6694483.html
- 基于webmagic的爬虫小应用
以前没有写过爬虫程序,最近两天就研究了一下java的爬虫框架webmagic.然后写了一个demo 写爬虫的基本思想: 1.抓取目标连接 2.根据页面中标签,抓捕你需要的内容 3.保存结果集 以下是实 ...
- slimScroll的应用(一)
本类文章依旧是针对初学者来说的,希望大家看到后觉得有用的能给个赞~~ 什么是slimScroll? 一.官网介绍: slimScroll is a small (4.6KB) jQuery plugi ...
- MySQL 当记录不存在时insert,当记录存在时更新
网上基本有三种解决方法. 第一种: 示例一:insert多条记录 假设有一个主键为 client_id 的 clients 表,可以使用下面的语句: INSERT INTO clients (clie ...
- 【学习笔记】深入理解js原型和闭包(13)——【作用域】和【上下文环境】
上文简单介绍了作用域,本文把作用域和上下文环境结合起来说一下,会理解的更深一些. 如上图,我们在上文中已经介绍了,除了全局作用域之外,每个函数都会创建自己的作用域,作用域在函数定义时就已经确定了.而不 ...
- android控件之webview和js与java交互
首先添加权限:<uses-permission android:name="android.permission.INTERNET"/> 布局文件: <Relat ...
- FPGA原型验证
为什么要做FPGA原型验证? FPGA原型验证可以在IC流片前对芯片功能和性能做出评估,同时,可以给软件设计人员提供验证平台.所有的设计,无论是SOC还是ASIC都需要被验证(功能和时序验证),以确保 ...