
elasticsearch Mapping使用自定义分词器
创建索引及配置分析器
PUT /my_index

{

    "settings": {

        "analysis": {

            "char_filter": {

                "&_to_and": {

                    "type":       "mapping",

                    "mappings": [ "& => and "]

            }},

            "filter": {

                "my_stopwords": {

                    "type":       "stop",

                    "stopwords": [ "the", "a" ]

            }},

            "analyzer": {

                "my_analyzer": {

                    "type":         "custom",

                    "char_filter":  [ "html_strip", "&_to_and" ],

                    "tokenizer":    "standard",

                    "filter":       [ "lowercase", "my_stopwords" ]

            }}

        }

    }

}
创建索引类型与Mapping使用分析器
PUT /my_index/_mapping/_doc

{

	"_doc": {

		"properties": {

			"title": {

				"type": "text",

				"analyzer": "my_analyzer",

				"search_analyzer": "my_analyzer",

				"search_quote_analyzer": "my_analyzer"

			}

		}

	}

}
插入数据
POST /my_index/_doc/1

{

"title":"the a <a>你好</a> & "

}
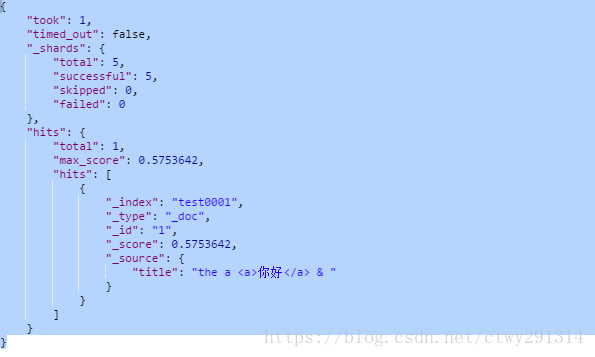
检索
POST /my_index/_search

{

	"query": {

	    "match": {

	      "title": "你好"

	    }

	}

}
&替换为and
POST /my_index/_search

{

	"query": {

	    "match": {

	      "title": "and"

	    }

	}

}
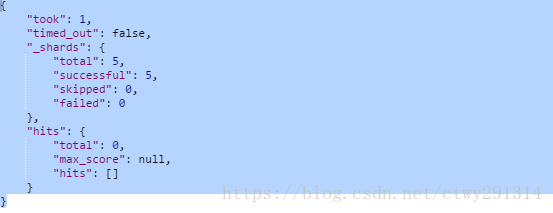
the a过滤停止词
POST /my_index/_search

{

	"query": {

	    "match": {

	      "title": "the a"

	    }

	}

}
elasticsearch Mapping使用自定义分词器的更多相关文章
- ElasticSearch教程——自定义分词器(转学习使用)
一.分词器 Elasticsearch中,内置了很多分词器(analyzers),例如standard(标准分词器).english(英文分词)和chinese(中文分词),默认是standard. ...
- Elasticsearch笔记六之中文分词器及自定义分词器
中文分词器 在lunix下执行下列命令,可以看到本来应该按照中文"北京大学"来查询结果es将其分拆为"北","京","大" ...
- 【分词器及自定义】Elasticsearch中文分词器及自定义分词器
中文分词器 在lunix下执行下列命令,可以看到本来应该按照中文”北京大学”来查询结果es将其分拆为”北”,”京”,”大”,”学”四个汉字,这显然不符合我的预期.这是因为Es默认的是英文分词器我需要为 ...
- Elasticsearch修改分词器以及自定义分词器
Elasticsearch修改分词器以及自定义分词器 参考博客:https://blog.csdn.net/shuimofengyang/article/details/88973597
- Elasticsearch(10) --- 内置分词器、中文分词器
Elasticsearch(10) --- 内置分词器.中文分词器 这篇博客主要讲:分词器概念.ES内置分词器.ES中文分词器. 一.分词器概念 1.Analysis 和 Analyzer Analy ...
- Elasticsearch Analyzer 内置分词器
Elasticsearch Analyzer 内置分词器 篇主要介绍一下 Elasticsearch中 Analyzer 分词器的构成 和一些Es中内置的分词器 以及如何使用它们 前置知识 es 提供 ...
- Elasticsearch拼音和ik分词器的结合应用
一.创建索引时,自定义拼音分词和ik分词 PUT /my_index { "index": { "analysis": { "analyzer&quo ...
- Elasticsearch(ES)分词器的那些事儿
1. 概述 分词器是Elasticsearch中很重要的一个组件,用来将一段文本分析成一个一个的词,Elasticsearch再根据这些词去做倒排索引. 今天我们就来聊聊分词器的相关知识. 2. 内置 ...
- elasticsearch使用ik中文分词器
elasticsearch使用ik中文分词器 一.背景 二.安装 ik 分词器 1.从 github 上找到和本次 es 版本匹配上的 分词器 2.使用 es 自带的插件管理 elasticsearc ...
随机推荐
- django报错
报错: SyntaxError Generator expression must be parenthesized 问题原因: 由于django 1.11版本和python3.7版本不兼容, 2.0 ...
- HDU 5634 线段树
题目链接:http://acm.hdu.edu.cn/showproblem.php?pid=5634 题意:给定一个长度为n的序列,有m次操作.操作有3种: 1 l,r :区间[l,r]的值变成ph ...
- Codeforces Round #394 (Div. 2) - A
题目链接:http://codeforces.com/contest/761/problem/A 题意:给定a个偶数,b个奇数,问是否能构成奇偶相间的阶梯.思路:a和b相差小于等于1即可构造出来.特判 ...
- [react-native]react-native填坑笔记
填坑笔记 开始入坑RN,从最开始的学起难免有不少乱七八糟的问题,记录在这里. 1. 8081端口占用问题 按照官网教程搭建开发环境并按照下面代码运行时候有报错,显示8081端口的问题 react-na ...
- linux中设置虚拟域名
一.打开tomcat安装目录下conf/server.xml这个文件在server.xml文档中找到 </Engine></Service> 接着添加上面添加以下内容(暂时先说 ...
- 【串线篇】Mybatis缓存之一级缓存
1.体会 一级缓存:MyBatis:SqlSesion级别的缓存:默认存在,不需要设置. 机制:只要之前查询过的数据,mybatis就会保存在一个缓存中(Map):下次获取直接从缓存中拿:当前sess ...
- springboot redis操作
redis五大类型用法 Redis五大类型:字符串(String).哈希/散列/字典(Hash).列表(List).集合(Set).有序集合(sorted set)五种Controller:@Reso ...
- KEGG注释
在 KEGG 数据库中,把功能相似的蛋白质归为同一组,然后标上 KO 号.通过相似性比对,可以为未知功能的蛋白序列注释上 KO 号. 截止到 2015 年 6 月 12 日,KEGG 数据库中共收录了 ...
- Oracle11g新建用户及用户表空间
/* 建立数据表空间 */CREATE TABLESPACE SP_TAB DATAFILE '/u01/app/oracle/oradata/orcl/tab1_1.dbf' size 1024M ...
- selenium环境搭建,浏览器驱动安装
一安装Python: 1.下载Phtyon地址:https://www.python.org/getit/ 2.安装python会默认安装两个基础包setuptools,pip 也可以手动安装: ...