
用python来抓取“煎蛋网”上面的美女图片,尺度很大哦!哈哈
所用Python环境为:python 3.3.2 用到的库为:urllib.request re
废话不多说,先上代码:
import urllib.request

import re

#获得当前页面的页数page_name

def get_pagenum(url):

    req = urllib.request.Request(url)

    req.add_header('User-Agent','Mozilla/5.0 (Windows NT 6.3; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/50.0.2661.102 Safari/537.36')

    res = urllib.request.urlopen(req)

    html = res.read().decode('utf-8')

    p = r'<span class="current-comment-page">[^"]+</span>'

    temp = re.search(p,html)

    page_num = temp.group()[36:39]

    return page_num

#将此页面上的图片写入我们的mm文件夹中

def get_img(page_url):

    req = urllib.request.Request(page_url)

    req.add_header('User-Agent','Mozilla/5.0 (Windows NT 6.3; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/50.0.2661.102 Safari/537.36')

    res = urllib.request.urlopen(req)

    html = res.read().decode('utf-8')

    p = r'<img src="([^"]+\.jpg)"'

    url_list = re.findall(p,html)

    num = 0

    for each in url_list:

        file = open('C:/Users/lenovo/Desktop/mm/'+each[-8:]+'.jpg','wb')

        if each[0:5] == 'http:':

            res = urllib.request.urlopen(each)

        else:

            res = urllib.request.urlopen('http:'+each)

        file.write(res.read())

        file.close()

#只能直接运行

if __name__ == '__main__':

    url = 'http://jandan.net/ooxx/'

    page_num = get_pagenum(url)

    for i in range(10):   #抓取了十个页面上美女图片

        page_url = url + 'page-'+str(page_num)+'#comments'

        get_img(page_url)

        page_num = int(page_num) - 1

#下面是写正则的时候方便看所以粘贴过来的连接

#<img src="//ws3.sinaimg.cn/mw600/006wUWIjgy1fgxrw8goikj30hs0qodh7.jpg" style="max-width: 480px; max-height: 750px;">

#http://jandan.net/ooxx/page-143#comments

#<span class="current-comment-page">[141]</span>

#  http://wx3.sinaimg.cn/mw600/661eb95cly1fgioxk7mk3j20xc1e01f1.jpg

#<img src="//wx1.sinaimg.cn/mw600/006wUWIjgy1fgxg2yj5f3j30g70s6dgw.jpg" style="max-width: 480px; max-height: 750px;">
结果如下:
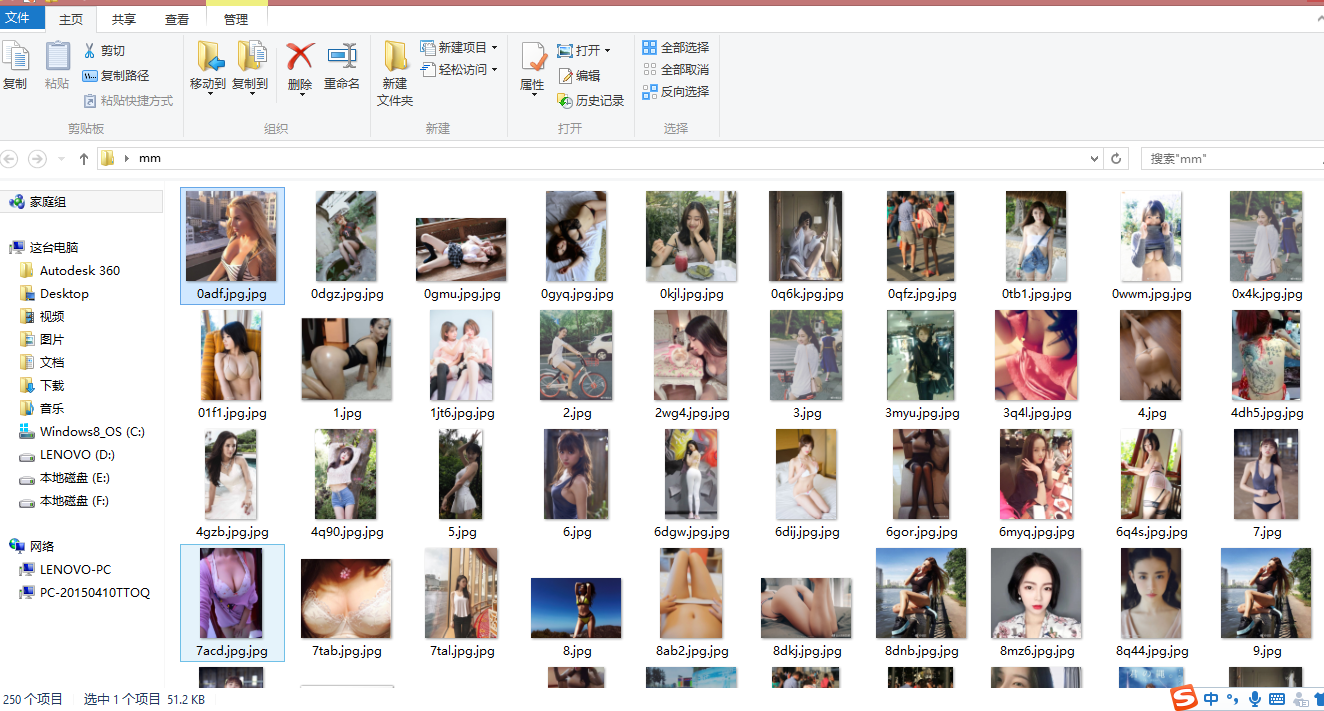
由于时间原因,我只抓取了“煎蛋网”上的十个页面的美女图片罢了,大家可以更改其中的循环次数,可以抓取很多,这里我只抓取了250个图片,一共51.2kb,哈哈,可以很好的欣赏美女图片了,看的都要流鼻血了。。。
当然,此程序还是不够完善,只是我初学python网络爬虫的小作品罢了,以后再些更加完善的。接下来的一段时间真的得好好准备期末考试和考研了,加油!
参考来源: https://zhuanlan.zhihu.com/p/26442105
Note:没有经过我的同意,请勿随便转载!谢谢。
用python来抓取“煎蛋网”上面的美女图片,尺度很大哦!哈哈的更多相关文章
- Python Scrapy 爬取煎蛋网妹子图实例(一)
前面介绍了爬虫框架的一个实例,那个比较简单,这里在介绍一个实例 爬取 煎蛋网 妹子图,遗憾的是 上周煎蛋网还有妹子图了,但是这周妹子图变成了 随手拍, 不过没关系,我们爬图的目的是为了加强实战应用,管 ...
- Python 爬虫 爬取 煎蛋网 图片
今天, 试着爬取了煎蛋网的图片. 用到的包: urllib.request os 分别使用几个函数,来控制下载的图片的页数,获取图片的网页,获取网页页数以及保存图片到本地.过程简单清晰明了 直接上源代 ...
- python爬虫–爬取煎蛋网妹子图片
前几天刚学了python网络编程,书里没什么实践项目,只好到网上找点东西做. 一直对爬虫很好奇,所以不妨从爬虫先入手吧. Python版本:3.6 这是我看的教程:Python - Jack -Cui ...
- Python Scrapy 爬取煎蛋网妹子图实例(二)
上篇已经介绍了 图片的爬取,后来觉得不太好,每次爬取的图片 都在一个文件下,不方便区分,且数据库中没有爬取的时间标识,不方便后续查看 数据时何时爬取的,所以这里进行了局部修改 修改一:修改爬虫执行方式 ...
- python爬虫爬取煎蛋网妹子图片
import urllib.request import os def url_open(url): req = urllib.request.Request(url) req.add_header( ...
- [Java]使用HttpClient实现一个简单爬虫,抓取煎蛋妹子图
第一篇文章,就从一个简单爬虫开始吧. 这只虫子的功能很简单,抓取到”煎蛋网xxoo”网页(http://jandan.net/ooxx/page-1537),解析出其中的妹子图,保存至本地. 先放结果 ...
- Golang分布式爬虫:抓取煎蛋文章|Redis/Mysql|56,961 篇文章
--- layout: post title: "Golang分布式爬虫:抓取煎蛋文章" date: 2017-04-15 author: hunterhug categories ...
- selenium爬取煎蛋网
selenium爬取煎蛋网 直接上代码 from selenium import webdriver from selenium.webdriver.support.ui import WebDriv ...
- python爬虫学习(1)__抓取煎蛋图片
#coding=utf-8 #python_demo 爬取煎蛋妹子图在本地文件夹 import requests import threading import time import os from ...
随机推荐
- jenkins 构建日程表配置
其中有5个参数 第一个是代表分钟 H 表示随机 第二个是代表小时 9-15/4 9点到下午三点期间的每隔4个小时 第三个是代表天 * 任意一天 第四个是代表月份 1-11 表示1到11月份 第五个是 ...
- CORE EF生成ORACLE数据库模型报错问题记录
需求:最近在新开发一套在LINUX运行的API接口,需要用到net core api框架以及oracle数据库,首先需要解决的就是连接数据库问题,由于是DBFirst 加上之前很多老表不规范,导致了c ...
- 3、详解 ESLint 规则 转自https://blog.csdn.net/bbsyi/article/details/88816637
什么是 ESLint ? ESLint 是在 ECMAScript/JavaScript 代码中识别和报告模式匹配的工具,它的目标是保证代码的一致性和避免错误.在许多方面,它和 JSLint.JSHi ...
- Ubuntu16.04 + caffe + cuda 环境搭建
1. sudo apt-get install libprotobuf-dev libleveldb-dev libsnappy-dev libopencv-dev libhdf5-serial-de ...
- LeetCode:627.交换工资
题目链接:https://leetcode-cn.com/problems/swap-salary/ 题目 给定一个 salary 表,如下所示,有 m = 男性 和 f = 女性 的值.交换所有的 ...
- struts访问jsp api内置对象的集中方式
1 default-action-ref元素改元素用来配置默认的action,如果struts找不到对应的action,就会调用这个默认的action 2 dmi处理方式是通过请求action中的一个 ...
- SAS.EnhancedEditor.dll 已加载,但找不到入口点DLLRegisterServer
SAS.EnhancedEditor.dll 已加载,但找不到入口点DLLRegisterServer 重新安装EnhancedEditor 安装Microsoft.NET Framework 3.5 ...
- 【uoj#94】【集训队互测2015】胡策的统计(集合幂级数)
题目传送门:http://uoj.ac/problem/94 这是一道集合幂级数的入门题目.我们先考虑求出每个点集的连通生成子图个数,记为$g_S$,再记$h_S$为点集$S$的生成子图个数,容易发现 ...
- idea自动在文件头中添加作者和创建时间
设置路径 : File -> Settings -> Editor -> File and Code Templates 定制头模板: /** * @Author: chancy * ...
- IDEA中使用git报错Permission denied (publickey)
最近在使用idea开发时,使用git拉取远程仓库的代码时,报错Permission denied (publickey),原因是因为ssh的密钥失效,必须得重新设置下ssh的密钥即可. 命令很简单,在 ...