
scala flatmap、reduceByKey、groupByKey
1、test.txt文件中存放
asd sd fd gf g

dkf dfd dfml dlf

dff gfl pkdfp dlofkp
// 创建一个Scala版本的Spark Context

val conf = new SparkConf().setAppName("wordCount")

val sc = new SparkContext(conf)

// 读取我们的输入数据

val input = sc.textFile(inputFile)

// 把它切分成一个个单词

val words = input.flatMap(line => line.split(" "))
//words为------------------
asd
sd
fd
gf
g
dkf
dfd
dfml
dlf
dff
gfl
pkdfp
dlofkp
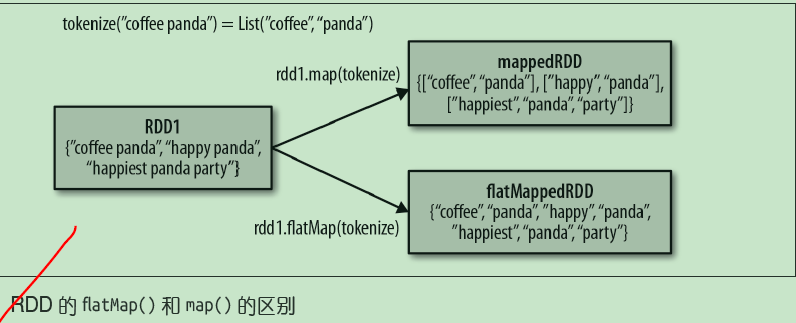
val counts = words.map(word => (word, 1)).reduceByKey{case (x, y) => x + y}

// 将统计出来的单词总数存入一个文本文件,引发求值

counts.saveAsTextFile(outputFile)
//reduceByKey 合并key计算

2、reduceByKey 合并key计算
按key求和

val rdd = sc.parallelize(List((“a”,2),(“b”,3),(“a”,3)))

合并key计算

val r1 = rdd.reduceByKey((x,y) => x + y)

输出结果如下

(a,5)

(b,3)
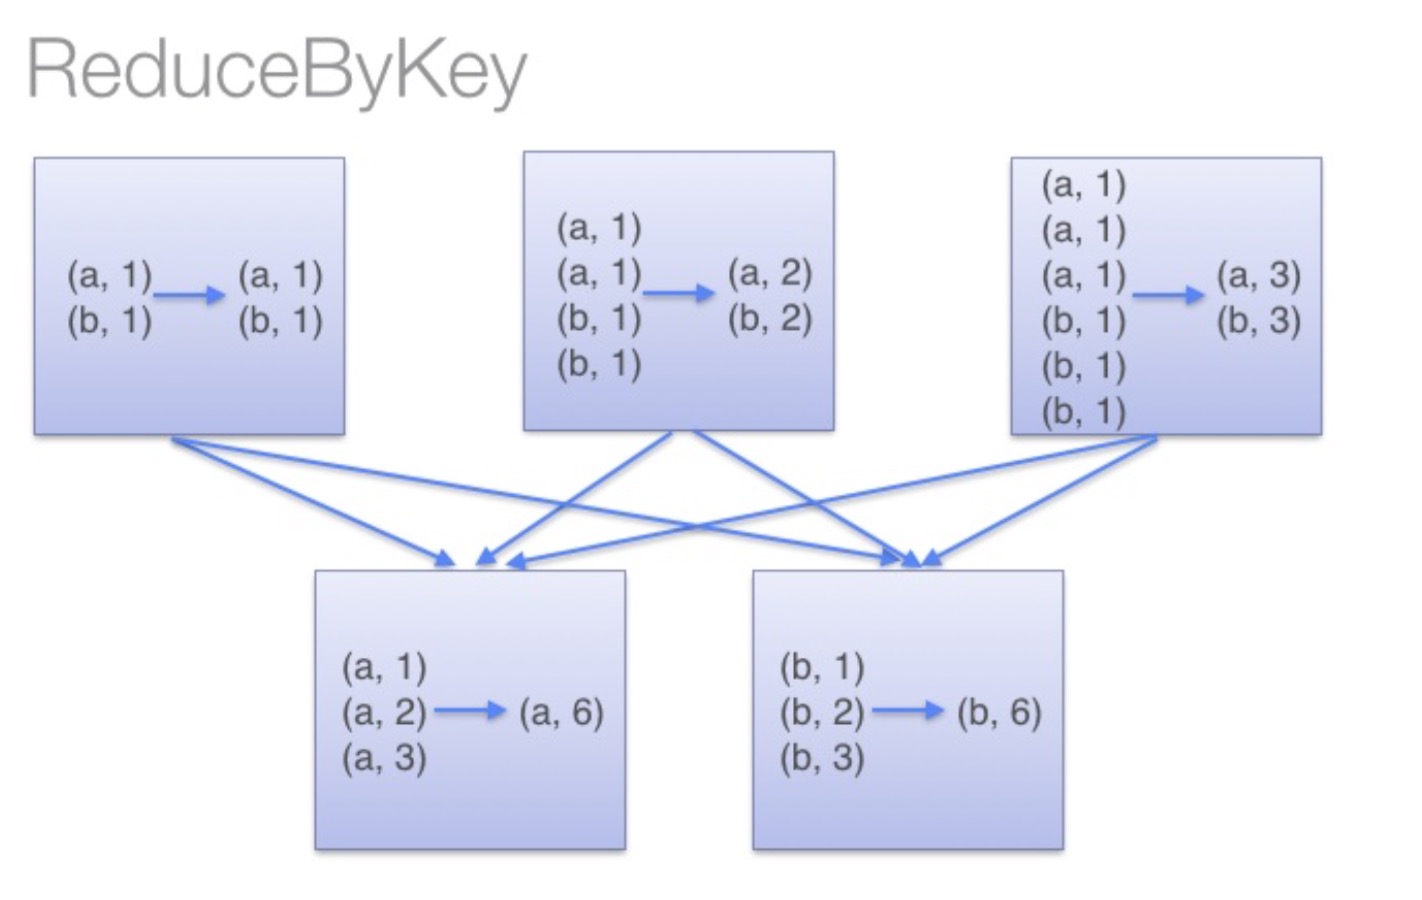
reduceByKey:reduceByKey会在结果发送至reducer之前会对每个mapper在本地进行merge,有点类似于在MapReduce中的combiner。
这样做的好处在于,在map端进行一次reduce之后,数据量会大幅度减小,从而减小传输,保证reduce端能够更快的进行结果计算。
groupByKey:groupByKey会对每一个RDD中的value值进行聚合形成一个序列(Iterator),
此操作发生在reduce端,所以势必会将所有的数据通过网络进行传输,造成不必要的浪费。
同时如果数据量十分大,可能还会造成OutOfMemoryError。
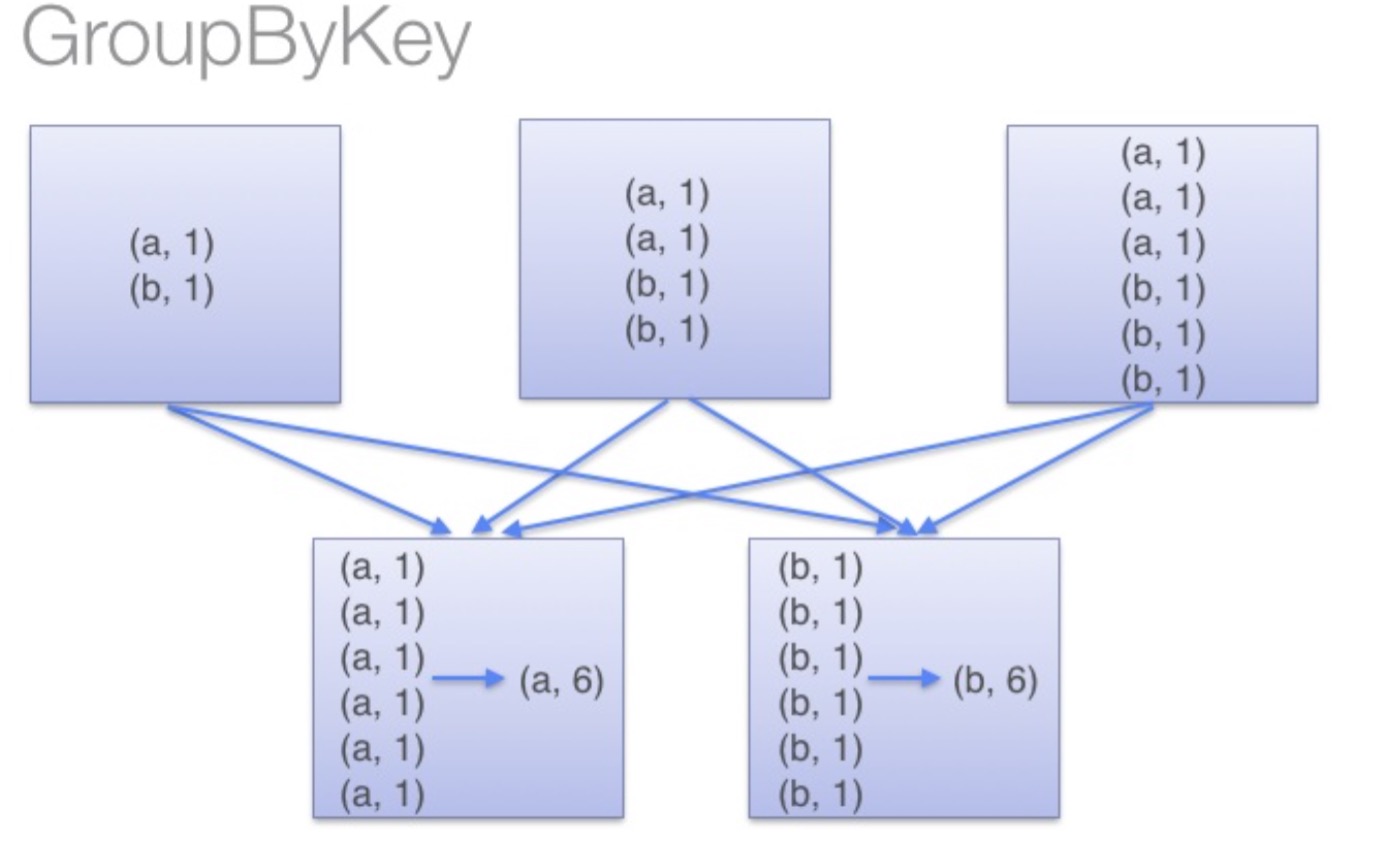
通过以上对比可以发现在进行大量数据的reduce操作时候建议使用reduceByKey。
不仅可以提高速度,还是可以防止使用groupByKey造成的内存溢出问题。


scala flatmap、reduceByKey、groupByKey的更多相关文章
- Spark RDD/Core 编程 API入门系列 之rdd案例(map、filter、flatMap、groupByKey、reduceByKey、join、cogroupy等)(四)
声明: 大数据中,最重要的算子操作是:join !!! 典型的transformation和action val nums = sc.parallelize(1 to 10) //根据集合创建RDD ...
- 32、reduceByKey和groupByKey对比
一.groupByKey 1.图解 val counts = pairs.groupByKey().map(wordCounts => (wordCounts._1, wordCounts._2 ...
- Spark记录-Spark性能优化(开发、资源、数据、shuffle)
开发调优篇 原则一:避免创建重复的RDD 通常来说,我们在开发一个Spark作业时,首先是基于某个数据源(比如Hive表或HDFS文件)创建一个初始的RDD:接着对这个RDD执行某个算子操作,然后得到 ...
- spark提交命令 spark-submit 的参数 executor-memory、executor-cores、num-executors、spark.default.parallelism分析
转载:https://blog.csdn.net/zimiao552147572/article/details/96482120 nohup spark-submit --master yarn - ...
- 转载-reduceByKey和groupByKey的区别
原文链接-https://www.cnblogs.com/0xcafedaddy/p/7625358.html 先来看一下在PairRDDFunctions.scala文件中reduceByKey和g ...
- reduceByKey和groupByKey的区别
先来看一下在PairRDDFunctions.scala文件中reduceByKey和groupByKey的源码 /** * Merge the values for each key using a ...
- Spark中groupByKey、reduceByKey与sortByKey
groupByKey把相同的key的数据分组到一个集合序列当中: [("hello",1), ("world",1), ("hello",1 ...
- 【Spark算子】:reduceByKey、groupByKey和combineByKey
在spark中,reduceByKey.groupByKey和combineByKey这三种算子用的较多,结合使用过程中的体会简单总结: 我的代码实践:https://github.com/wwcom ...
- 深入理解groupByKey、reduceByKey区别——本质就是一个local machine的reduce操作
下面来看看groupByKey和reduceByKey的区别: val conf = new SparkConf().setAppName("GroupAndReduce").se ...
随机推荐
- vue 数据绑定实现的核心 Object.defineProperty()
vue深入响应式原理 现在是时候深入一下了!Vue 最独特的特性之一,是其非侵入性的响应式系统.数据模型仅仅是普通的 JavaScript 对象.而当你修改它们时,视图会进行更新.这使得状态管理非常简 ...
- 【适合N卡独显电脑的环境配置】Tensorflow教程-Windows 10下安装tensorflow 1.5.0 GPU with Anaconda
注意: 1.目前Anaconda 更新原命令activate tensorflow 改为 conda activate tensorflow 2. 目前windows with anaconda 可以 ...
- ssm框架的整合搭建(三)
mybatis逆向工程工具类的使用---mybatis generator 项目结构 配置文件 <?xml version="1.0" encoding="UTF ...
- Java中class的getName()和getCanonicalName()两个方法的区别
getName()返回的是虚拟机里面的class的表示 getCanonicalName()返回的是更容易理解的表示 对于普通类来说,二者没什么区别,只是对于特殊的类型上有点表示差异 比如byte[] ...
- 小技巧:改变 VS Code 工作区页面背景
效果图: 步骤(一): 1.点击页面左上角 文件/首选项/设置 2.在搜索框中输入:background 如下图. 3.找到 Background: Custom Images 选项并点击在 ...
- 【开源】 bsf.mvc spingboot的扩展
springboot的扩展实现,让springboot开发更加简单:形成demo模板,以后开发更方便. 开源地址:https://gitee.com/chejiangyi/bsf.mvc/tree/m ...
- Pessimistic and Optimistic locking
事务隔离通常通过锁定任何对事务中资源的访问来实现的.总的来说,有两种方法针对事务的锁定:乐观锁(Pessimistic locking)和悲观锁(Optimistic locking) 悲观锁(Pes ...
- 在线流媒体nginx/Windows解决方案
1,下载安装nginx这里是1.15.10,修改默认端口,看到测试页即可 2,conf文件中加入flv支持 location ~ .flv { flv; } 3,把mp4文件转码,使用ffmpeg-2 ...
- Python全栈开发之路 【第六篇】:Python基础之常用模块
本节内容 模块分类: 好处: 标准库: help("modules") 查看所有python自带模块列表 第三方开源模块: 自定义模块: 模块调用: import module f ...
- python之subprocess模块详解--小白博客
subprocess模块 subprocess是Python 2.4中新增的一个模块,它允许你生成新的进程,连接到它们的 input/output/error 管道,并获取它们的返回(状态)码.这个模 ...