
使用scrapy爬虫,爬取17k小说网的案例-方法一
无意间看到17小说网里面有一些小说小故事,于是决定用爬虫爬取下来自己看着玩,下图这个页面就是要爬取的来源。
a
这个页面一共有125个标题,每个标题里面对应一个内容,如下图所示
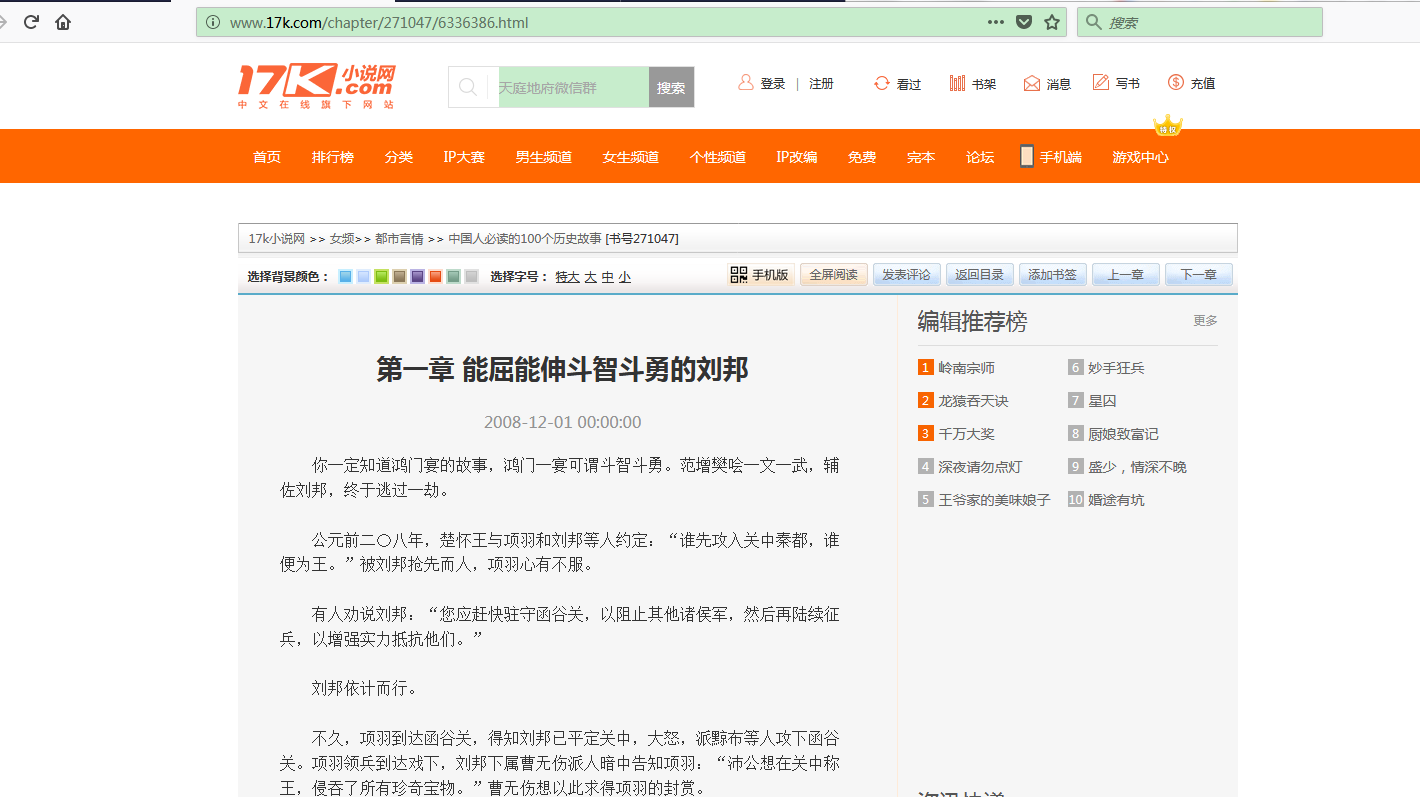
下面直接看最核心spiders中的代码
# -*- coding: utf-8 -*-

import scrapy

from k17.items import K17Item

import json

class A17kSpider(scrapy.Spider):

    name = '17k'

    allowed_domains = ['17k.com']

    start_urls = ['http://www.17k.com/list/271047.html']

    def parse(self, response):

        old_url='http://www.17k.com'


        for bb in response.xpath('//div[@class="Main List"]/dl[@class="Volume"]/dd'):

            ##把xpath表达式作为normalize-space()函数的参数 此方法可以去除数据的值有\r\n\t

            link=bb.xpath("a/@href").extract()
            for newurl in link:

                new_url=old_url+newurl

                yield scrapy.Request(new_url, callback=self.parse_item)

    def parse_item(self,response):

        for aa in response.xpath('//div[@class="readArea"]/div[@class="readAreaBox content"]'):

            item=K17Item()

            title=aa.xpath("h1/text()").extract()###得到每一章的标题

            new_title=(''.join(title).replace('\n','')).strip()

            item['title']=new_title

            dec= aa.xpath("div[@class='p']/text()").extract()###得到每一章的详细内容

            dec_new=((''.join(dec).replace('\n','')).replace('\u3000','')).strip() ###去除内容中的\n 和\u3000和空格的问题

            item['describe'] = dec_new

            yield item
使用scrapy爬虫,爬取17k小说网的案例-方法一的更多相关文章
- 使用scrapy爬虫,爬取17k小说网的案例-方法二
楼主准备爬取此页面的小说,此页面一共有125章 我们点击进去第一章和第一百二十五章发现了一个规律 我们看到此链接的 http://www.17k.com/chapter/271047/6336386 ...
- 使用scrapy爬虫,爬取起点小说网的案例
爬取的页面为https://book.qidian.com/info/1010734492#Catalog 爬取的小说为凡人修仙之仙界篇,这边小说很不错. 正文的章节如下图所示 其中下面的章节为加密部 ...
- Python的scrapy之爬取顶点小说网的所有小说
闲来无事用Python的scrapy框架练练手,爬取顶点小说网的所有小说的详细信息. 看一下网页的构造: tr标签里面的 td 使我们所要爬取的信息 下面是我们要爬取的二级页面 小说的简介信息: 下面 ...
- 利用Python网络爬虫爬取学校官网十条标题
利用Python网络爬虫爬取学校官网十条标题 案例代码: # __author : "J" # date : 2018-03-06 # 导入需要用到的库文件 import urll ...
- scrapy实例:爬取中国天气网
1.创建项目 在你存放项目的目录下,按shift+鼠标右键打开命令行,输入命令创建项目: PS F:\ScrapyProject> scrapy startproject weather # w ...
- Python的scrapy之爬取链家网房价信息并保存到本地
因为有在北京租房的打算,于是上网浏览了一下链家网站的房价,想将他们爬取下来,并保存到本地. 先看链家网的源码..房价信息 都保存在 ul 下的li 里面 爬虫结构: 其中封装了一个数据库处理模 ...
- 使用scrapy爬虫,爬取今日头条搜索吉林疫苗新闻(scrapy+selenium+PhantomJS)
这一阵子吉林疫苗案,备受大家关注,索性使用爬虫来爬取今日头条搜索吉林疫苗的新闻 依然使用三件套(scrapy+selenium+PhantomJS)来爬取新闻 以下是搜索页面,得到吉林疫苗的搜索信息, ...
- Python 爬虫 爬取 煎蛋网 图片
今天, 试着爬取了煎蛋网的图片. 用到的包: urllib.request os 分别使用几个函数,来控制下载的图片的页数,获取图片的网页,获取网页页数以及保存图片到本地.过程简单清晰明了 直接上源代 ...
- <scrapy爬虫>爬取360妹子图存入mysql(mongoDB还没学会,学会后加上去)
1.创建scrapy项目 dos窗口输入: scrapy startproject images360 cd images360 2.编写item.py文件(相当于编写模板,需要爬取的数据在这里定义) ...
随机推荐
- Java的selenium代码随笔(7)
//判断元素是否存在public boolean IsElementPresent (WebElement webElement, By by) { boolean status = false; t ...
- [蓝桥杯]2017蓝桥省赛B组题目及详解
/*——————————————————————————————————————————————————————————— [结果填空题]T1 (分值:5) 题目:购物单 小明刚刚找到工作,老板人很好 ...
- K3CLOUDJOBPROCESS每分钟重启
1.进入服务,找到k3cloudjobprocess 2.设置每分钟重启
- AtCoder ABC 042D いろはちゃんとマス目 / Iroha and a Grid
题目链接:https://abc042.contest.atcoder.jp/tasks/arc058_b 题目大意: 给定一个 H * W 的矩阵,其中左下角 A * B 区域是禁区,要求在不踏入禁 ...
- Linux调整日期时间
Linux日期不准确,要更改 Linux 系统整个系统范围的时区可以使用如下命令: sudo rm -f /etc/localtime sudo ln -s /usr/share/zoneinfo/A ...
- 基于Python清除破损图片需求实现
处理同事爬取的图片时,其因爬取过程中因图片类型/网络等问题,获取到较大批次破损图片,现需清除破损文件,并做简要记录. 要点: 在python中,可以使⽤imghdr模块中的what()⽅法判断图⽚⽂件 ...
- 【C++】GSL(GNU Scientific Library) 的安装及在 Visual Studio 2017 中的使用
GSL 是 GNU 开发并维护的科学计算的库,其中包括: 复数 多项式的根 特殊函数 向量和矩阵 排列 排序 BLAS支持 线性代数 Eigensystems 快速傅立叶变换 正交 随机数 准随机序列 ...
- My Todo-List
有些事情要明着写出来才会去干. 这里是一个不断更新的Todo-List,大致按照重要度和列出时间排序. 主要着眼短期计划,其中的大部分事务应该在一周内解决,争取不做一只鸽子. 填好模板库的坑. 学习树 ...
- MFC:位图和图标的设置
一. 图标的设置 加载图标 API函数:AfxGetApp()->LoadIconW(); 2. 显示图标 API函数:SetClassLong(); 函数原型:DWORD WINAPI S ...
- sql笔试题
笔试题1: 1.select * from tablex where name = "张*" order by age 默认升序 select * from table ...