
<scrapy爬虫>爬取360妹子图存入mysql(mongoDB还没学会,学会后加上去)
1.创建scrapy项目
dos窗口输入:
scrapy startproject images360
cd images360
2.编写item.py文件(相当于编写模板,需要爬取的数据在这里定义)
import scrapy

class Images360Item(scrapy.Item):

    # define the fields for your item here like:

    #图片ID

    image_id = scrapy.Field()

    #链接

    url = scrapy.Field()

    #标题

    title = scrapy.Field()

    #缩略图

    thumb = scrapy.Field()
3.创建爬虫文件
dos窗口输入:
scrapy genspider myspider images.so.com
4.编写myspider.py文件(接收响应,处理数据)
# -*- coding: utf-8 -*-

from urllib.parse import urlencode

import scrapy

from images360.items import Images360Item

import json

class MyspiderSpider(scrapy.Spider):

    name = 'myspider'

    allowed_domains = ['images.so.com']

    urls = []

    data = {'ch': 'beauty', 'listtype': 'new'}

    base_url = 'https://image.so.com/zj?0'

    for page in range(1,51):

        data['sn'] = page * 30

        params = urlencode(data)

        url = base_url + params

        urls.append(url)

    print(urls)

    start_urls = urls

    # ch: beauty

    # sn: 120

    # listtype: new

    # temp: 1

    def parse(self, response):

        result = json.loads(response.text)

        for each in result.get('list'):

            item = Images360Item()

            item['image_id'] = each.get('imageid')

            item['url'] = each.get('qhimg_url')

            item['title'] = each.get('group_title')

            item['thumb'] = each.get('qhimg_thumb_url')

            yield item
5.编写pipelines.py(存储数据)
import pymysql.cursors

class Images360Pipeline(object):

    def __init__(self):

        self.connect = pymysql.connect(

            host='localhost',

            user='root',

            password='',

            database='quotes',

            charset='utf8',

        )

        self.cursor = self.connect.cursor()

    def process_item(self, item, spider):

        item = dict(item)

        sql = 'insert into images360(image_id,url,title,thumb) values(%s,%s,%s,%s)'

        self.cursor.execute(sql, (item['image_id'], item['url'], item['title'],item['thumb']))

        self.connect.commit()

        return item

    def close_spider(self, spider):

        self.cursor.close()

        self.connect.close()
6.编写settings.py(设置headers,pipelines等)
robox协议
# Obey robots.txt rules

ROBOTSTXT_OBEY = False
headers
DEFAULT_REQUEST_HEADERS = {

    'user-agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/68.0.3440.106 Safari/537.36',

    'Accept': 'text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8',

  # 'Accept-Language': 'en',

}
pipelines
ITEM_PIPELINES = {

   'quote.pipelines.Images360Pipeline': 300,

}
7.运行爬虫
dos窗口输入:
scrapy crawl myspider
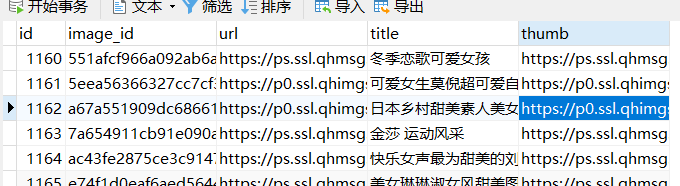
运行结果
<scrapy爬虫>爬取360妹子图存入mysql(mongoDB还没学会,学会后加上去)的更多相关文章
- 写一个python 爬虫爬取百度电影并存入mysql中
目标是利用python爬取百度搜索的电影 在类型 地区 年代各个标签下 电影的名字 评分 和图片连接 以及 电影连接 首先我们先在mysql中建表 create table liubo4( id in ...
- Scrapy框架学习(四)爬取360摄影美图
我们要爬取的网站为http://image.so.com/z?ch=photography,打开开发者工具,页面往下拉,观察到出现了如图所示Ajax请求, 其中list就是图片的详细信息,接着观察到每 ...
- 使用scrapy爬虫,爬取17k小说网的案例-方法一
无意间看到17小说网里面有一些小说小故事,于是决定用爬虫爬取下来自己看着玩,下图这个页面就是要爬取的来源. a 这个页面一共有125个标题,每个标题里面对应一个内容,如下图所示 下面直接看最核心spi ...
- <scrapy爬虫>爬取猫眼电影top100详细信息
1.创建scrapy项目 dos窗口输入: scrapy startproject maoyan cd maoyan 2.编写item.py文件(相当于编写模板,需要爬取的数据在这里定义) # -*- ...
- <scrapy爬虫>爬取quotes.toscrape.com
1.创建scrapy项目 dos窗口输入: scrapy startproject quote cd quote 2.编写item.py文件(相当于编写模板,需要爬取的数据在这里定义) import ...
- scrapy爬虫爬取小姐姐图片(不羞涩)
这个爬虫主要学习scrapy的item Pipeline 是时候搬出这张图了: 当我们要使用item Pipeline的时候,要现在settings里面取消这几行的注释 我们可以自定义Item Pip ...
- 使用scrapy爬虫,爬取今日头条搜索吉林疫苗新闻(scrapy+selenium+PhantomJS)
这一阵子吉林疫苗案,备受大家关注,索性使用爬虫来爬取今日头条搜索吉林疫苗的新闻 依然使用三件套(scrapy+selenium+PhantomJS)来爬取新闻 以下是搜索页面,得到吉林疫苗的搜索信息, ...
- <scrapy爬虫>爬取校花信息及图片
1.创建scrapy项目 dos窗口输入: scrapy startproject xiaohuar cd xiaohuar 2.编写item.py文件(相当于编写模板,需要爬取的数据在这里定义) # ...
- <scrapy爬虫>爬取腾讯社招信息
1.创建scrapy项目 dos窗口输入: scrapy startproject tencent cd tencent 2.编写item.py文件(相当于编写模板,需要爬取的数据在这里定义) # - ...
随机推荐
- 区别 |python-pandas库set_index、reset_index用法区别
1.set_index() 作用:DataFrame可以通过set_index方法,将普通列设置为单索引/复合索引. 格式:DataFrame.set_index(keys, drop=True, a ...
- Kotlin Doc
{ https://www.runoob.com/kotlin/kotlin-eclipse-setup.html }
- IDEA使用的JDK版本1.9换成1.8后,在IDEA中需要改的配置
今天上午上课spring5使用注解方式的时候,发现jdk9不兼容,果断换jdk8 步骤如下 一.查看Project中的jdk 1.检查Project SDK:中jdk 版本是否为1.8版本 2.检查P ...
- 禁用NX软件启动欢迎界面[转载]
环境变量UGII_BACKGROUND_URL NONE 转载自https://www.ugnx.net/wt/414
- [Nowcoder] 数数字
题意:...咕咕懒得写了. 思路: 裸的记搜... #include <bits/stdc++.h> using namespace std; #define ll long long m ...
- hdu多校第五场1004 (hdu6627) equation 1 计算几何
题意: 给你一个C,再给你n组a,b,让你求x取什么值的时候,$ \sum_{i=1}^n |a_i*x+b_i| =C $,要求求出解的个数,并用最简分数从小到大表示,如果有无穷多解,输出-1. 题 ...
- day 89 DjangoRestFramework学习三之认证组件、权限组件、频率组件、url注册器、响应器、分页组件
DjangoRestFramework学习三之认证组件.权限组件.频率组件.url注册器.响应器.分页组件 本节目录 一 认证组件 二 权限组件 三 频率组件 四 URL注册器 五 响应器 六 分 ...
- scala 常用模式匹配类型
模式匹配的类型 包括: 常量模式 变量模式 构造器模式 序列模式 元组模式 变量绑定模式等. 常量模式匹配 常量模式匹配,就是在模式匹配中匹配常量 objectConstantPattern{ def ...
- 04E: Sub-process /usr/bin/dpkg returned an error code (1)
- 【LGP5127】子异和
题目 子异和这个名字,真是思博 显然一个集合的子集异或和为,\(2^{|S|-1}\times A\),\(A\)为集合的或和 于是现在的问题变成了树链异或一个数,求树链或和 显然强行拆位是可以做的, ...