
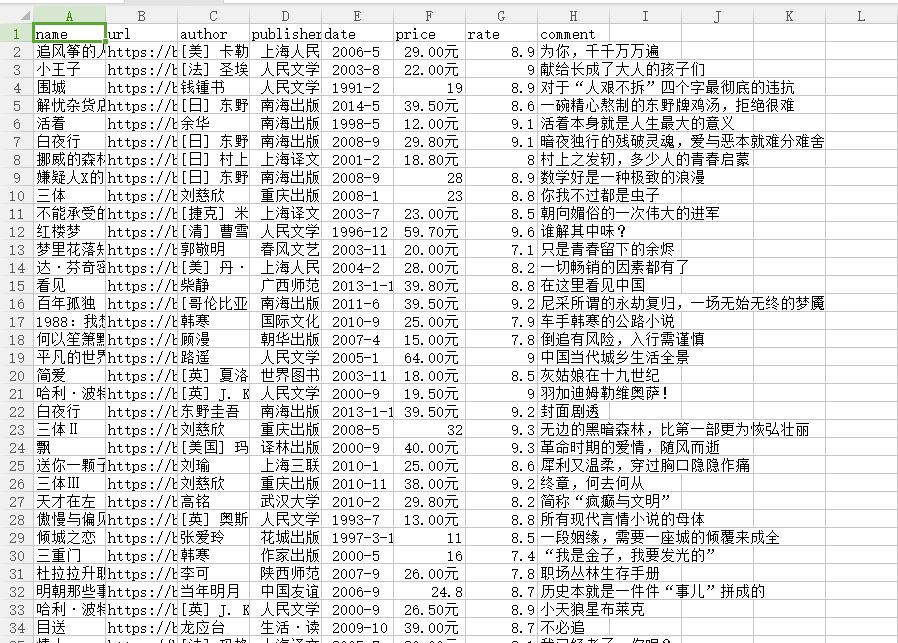
爬去豆瓣图书top250数据存储到csv中
from lxml import etree

import requests

import csv

fp=open('C://Users/Administrator/Desktop/lianxi/doubanbook.csv','w+',newline='',encoding='utf-8')

writer=csv.writer(fp)

writer.writerow(('name','url','author','publisher','date','price','rate','comment'))

headers={

    #'User-Agent':'Nokia6600/1.0 (3.42.1) SymbianOS/7.0s Series60/2.0 Profile/MIDP-2.0 Configuration/CLDC-1.0'

    'User-Agent':'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/55.0.2883.87 Safari/537.36'

}

urls=['https://book.douban.com/top250?start={}'.format(str(i))for i in range(0,50,25)]

for url in urls:

    html=requests.get(url,headers=headers)

    selector=etree.HTML(html.text)

    infos=selector.xpath('//tr[@class="item"]')

    for info in infos:

        name=info.xpath('td/div/a/@title')[0]

        url=info.xpath('td/div/a/@href')[0]

        book_infos=info.xpath('td/p/text()')[0]

        author=book_infos.split('/')[0]

        publisher=book_infos.split('/')[-3]

        date=book_infos.split('/')[-2]

        price=book_infos.split('/')[-1]

        rate=info.xpath('td/div/span[2]/text()')[0]

        comments=info.xpath('td/p/span/text()')

        comment=comments[0] if len(comments) != 0 else "空"

        writer.writerow((name,url,author,publisher,date,price,rate,comment))

fp.close()
爬去豆瓣图书top250数据存储到csv中的更多相关文章
- Python 2.7_利用xpath语法爬取豆瓣图书top250信息_20170129
大年初二,忙完家里一些事,顺带有人交流爬取豆瓣图书top250 1.构造urls列表 urls=['https://book.douban.com/top250?start={}'.format(st ...
- Python爬虫-爬取豆瓣图书Top250
豆瓣网站很人性化,对于新手爬虫比较友好,没有如果调低爬取频率,不用担心会被封 IP.但也不要太频繁爬取. 涉及知识点:requests.html.xpath.csv 一.准备工作 需要安装reques ...
- 实例学习——爬取豆瓣音乐TOP250数据
开发环境:(Windows)eclipse+pydev+MongoDB 豆瓣TOP网址:传送门 一.连接数据库 打开MongoDBx下载路径,新建名为data的文件夹,在此新建名为db的文件夹,d ...
- 实例学习——爬取豆瓣网TOP250数据
开发环境:(Windows)eclipse+pydev 网址:https://book.douban.com/top250?start=0 from lxml import etree #解析提取数据 ...
- 爬取豆瓣电影top250并存储到mysql数据库
import requests from lxml import etree import re import pymysql import time conn= pymysql.connect(ho ...
- python爬虫1——获取网站源代码(豆瓣图书top250信息)
# -*- coding: utf-8 -*- import requests import re import sys reload(sys) sys.setdefaultencoding('utf ...
- python系列之(3)爬取豆瓣图书数据
上次介绍了beautifulsoup的使用,那就来进行运用下吧.本篇将主要介绍通过爬取豆瓣图书的信息,存储到sqlite数据库进行分析. 1.sqlite SQLite是一个进程内的库,实现了自给自足 ...
- 【Python数据分析】Python3操作Excel-以豆瓣图书Top250为例
本文利用Python3爬虫抓取豆瓣图书Top250,并利用xlwt模块将其存储至excel文件,图片下载到相应目录.旨在进行更多的爬虫实践练习以及模块学习. 工具 1.Python 3.5 2.Bea ...
- 【Python数据分析】Python3多线程并发网络爬虫-以豆瓣图书Top250为例
基于上两篇文章的工作 [Python数据分析]Python3操作Excel-以豆瓣图书Top250为例 [Python数据分析]Python3操作Excel(二) 一些问题的解决与优化 已经正确地实现 ...
随机推荐
- CodeForces 467D(267Div2-D)Fedor and Essay (排序+dfs)
D. Fedor and Essay time limit per test 2 seconds memory limit per test 256 megabytes input standard ...
- Django 中得ORM介绍和字段及字段参数
ORM 介绍 ORM概念 对象关系映射(Object Relational Mapping,简称ORM)模式是一种为了解决面向对象与关系数据库存在的互不匹配的现象的技术. 简单的说 ORM 是通过使用 ...
- Linux系统下使用split命令分割大文件 (转载)
原创作品,允许转载,转载时请务必以超链接形式标明文章 原始出处 .作者信息和本声明.否则将追究法律责任.http://snailwarrior.blog.51cto.com/680306/140531 ...
- Netty入门系列(3) --使用Netty进行编解码的操作
前言 何为编解码,通俗的来说,我们需要将一串文本信息从A发送到B并且将这段文本进行加工处理,如:A将信息文本信息编码为2进制信息进行传输.B接受到的消息是一串2进制信息,需要将其解码为文本信息才能正常 ...
- 洛谷 - P2324 - 骑士精神 - A*搜索
为什么估价是16,因为最后一步复原空格可以恢复两个位置,当然设成17.18都可以. #include<bits/stdc++.h> using namespace std; typedef ...
- codevs 1086 栈(Catalan数)
题目描述 Description 栈是计算机中经典的数据结构,简单的说,栈就是限制在一端进行插入删除操作的线性表. 栈有两种最重要的操作,即pop(从栈顶弹出一个元素)和push(将一个元素进栈). ...
- P4769 [NOI2018]冒泡排序(dp)
传送门 日常膜拜shadowice巨巨的题解 //minamoto #include<bits/stdc++.h> #define R register #define ll long l ...
- 洛谷P1074 靶形数独(跳舞链)
传送门 坑着,等联赛之后再填(联赛挂了就不填了233) //minamoto #include<iostream> #include<cstdio> #include<c ...
- 洛谷P3190 [HNOI2007]神奇游乐园(插头dp)
传送门 大概是算第一道自己做出来的插头dp? (虽然都是照着抄板子的) (虽然有个地方死活没调出来最后只能看题解才发现自己错在哪里的) 我就当你们都会插头dp了…… 因为必须得是一条路径,所以扫描线上 ...
- MyBatis入门Bug集锦X1