
Coursera, Big Data 1, Introduction (week 1/2)
Status: week 2 done.
Week 1, 主要讲了大数据的的来源 - 机器产生的数据,人产生的数据(比如社交软件上的update, 一般是unstructed data), 组织产生的数据(一般是structured data)
怎么把unstructured data 转化成 structured data?
利用 Hadoop, Storm, Spark and NoSQL. Hadoop 能解决data量大的问题,因为它是支持分布式计算的。 Storm 和 Spark 能分析像社交应用这种短时间内产生大量实时数据的情况, 还能和任何类型的DB集成.
传统的数据仓库是下面这样的。structed data 存在data warehouse里.
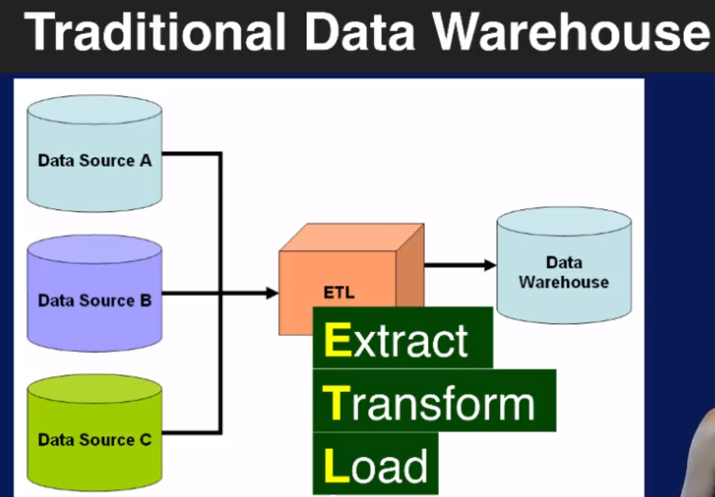
而现在的大数据时代,很多企业都是采用hybrid方案 - 把少量数据存在structured DB里,而更多的数据放在云上的 NoSQL DB里.
下面是两种NoSQL类型的数据库
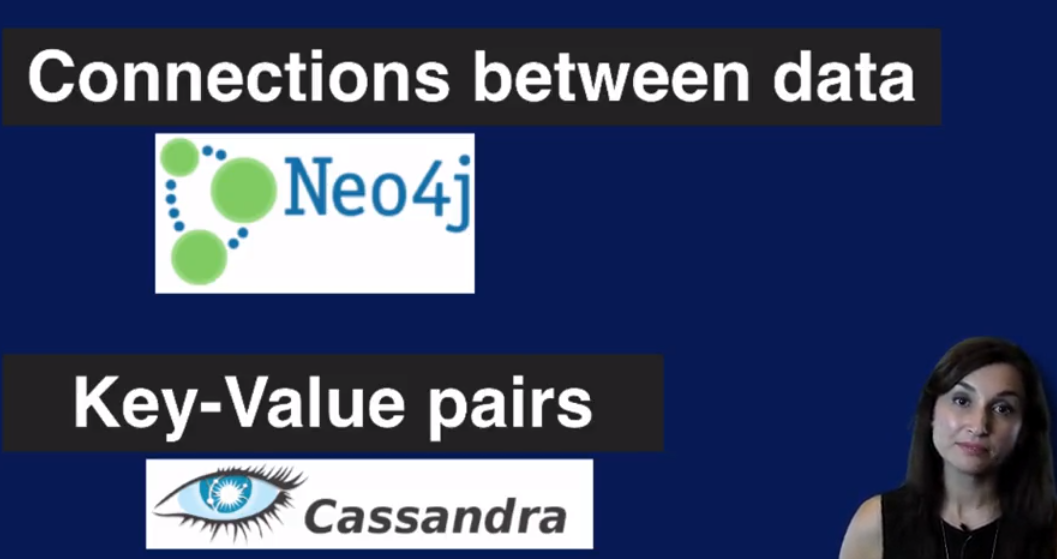
Neo4j - graph db
Cassandra - key value db
Week 2
big data 的特征可以用几个V来概括.
Volume - Scale of data
Velocity (=Speed) - Analysis of streaming data (数据产生快,存储快,处理快)
Variety - Different forms of data
Veracity (=Quality) - Uncertainty of data
Valence - Connectness of big data in the forms of graphs
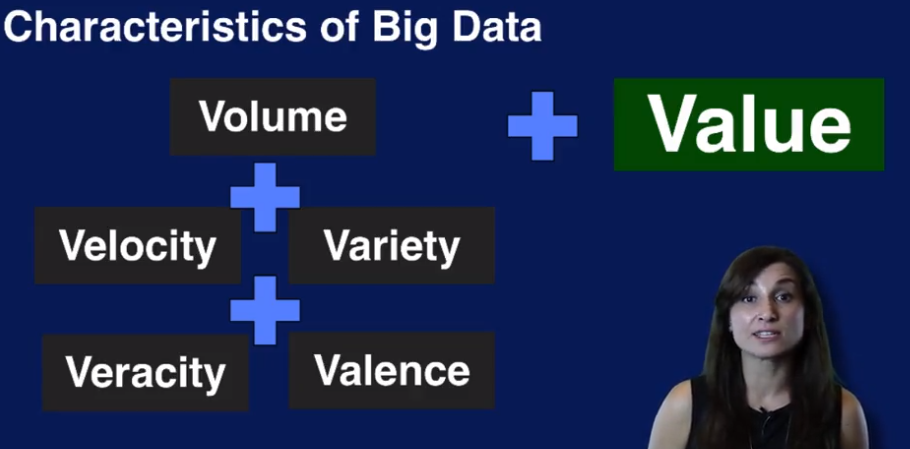
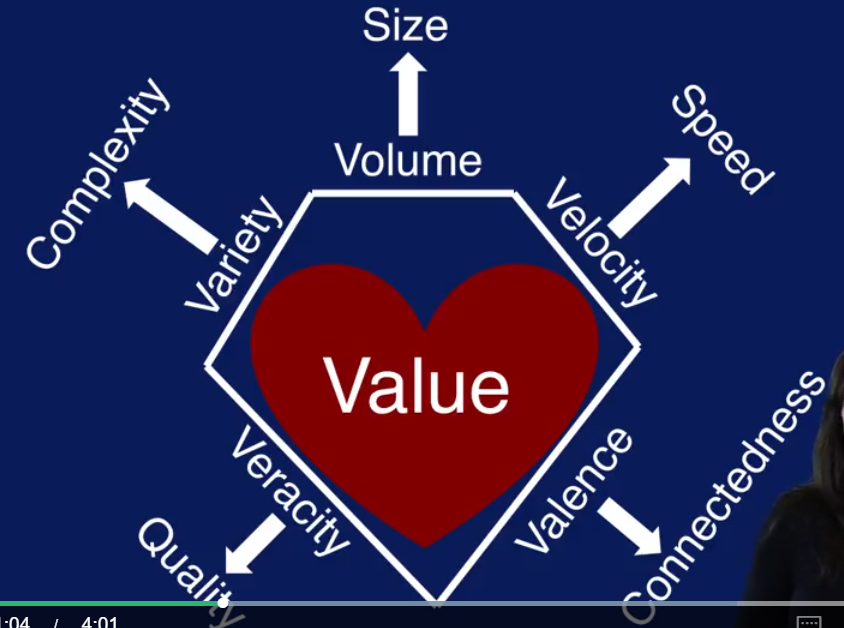
Getting value out of big data: 分析 big data, 形成 insight, 进而转化为 Action.
一个data stientist 应该具有相关的 technical skills, bussiness skills 和 soft skills, 并且因为需要的技能很多,最好形成团队来做一件事情.
Buiding a big data strategy:
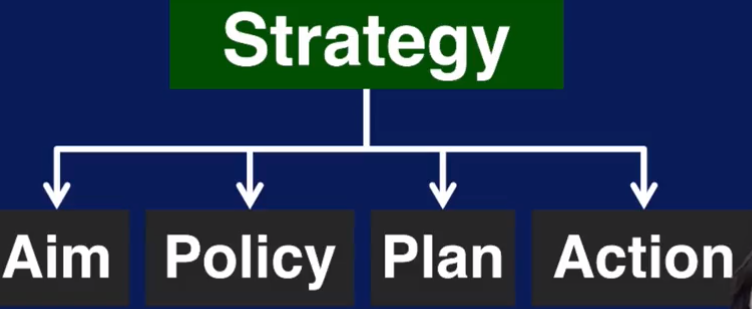
strategy 要成功,需要管理层的支持,一个多技能的团队,相应的培训,一个测试idea 的mini lab, 移除存取数据的障碍
数据科学的5个P
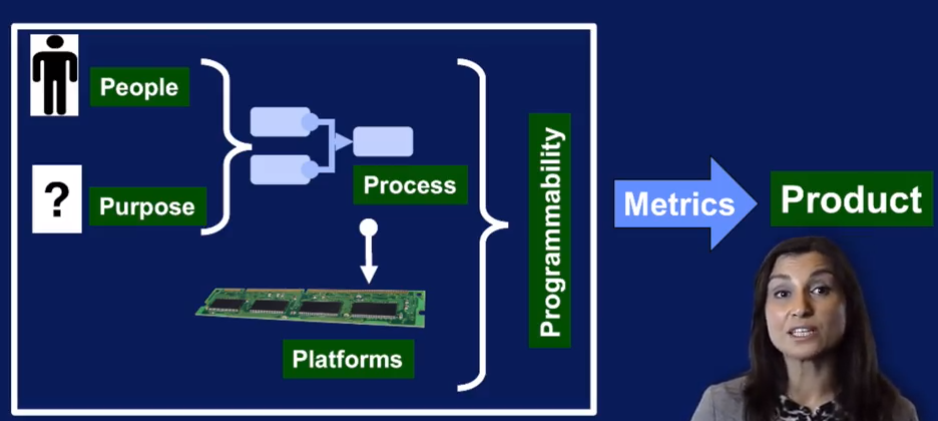
Steps in the data science process
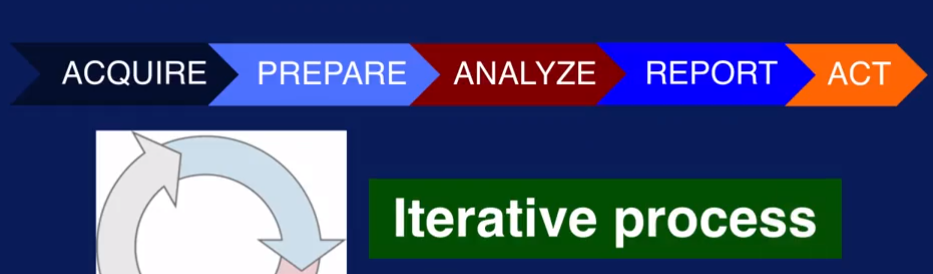
1. 获取原数据
从哪里获取,通过什么技术?
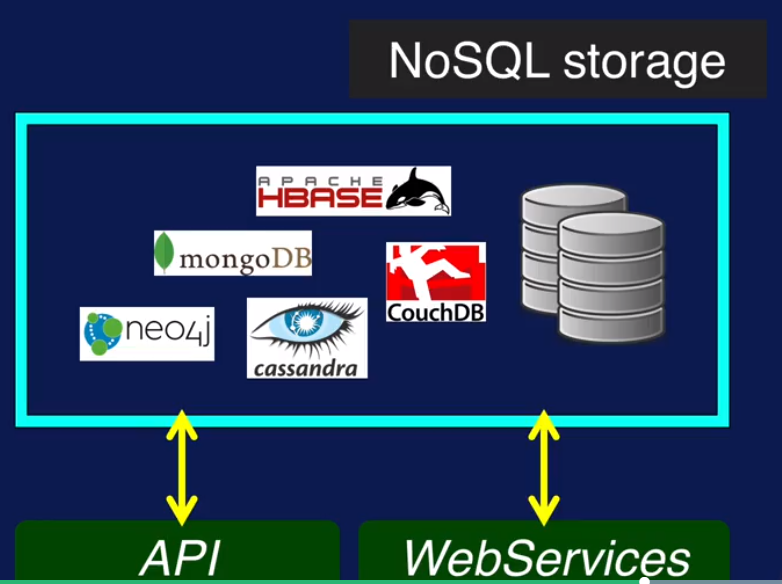
数据有结构化和非结构化的,来自不同来源. 结构化数据可以通过SQL 读取. 来自文件的data 可以通过Python等脚本语言读取. 远程数据(格式可能是xml, html, json ) 通过web service (rest, soap, web socket) 读取. 非结构化数据可以通过非结构数据库提供的API或者web service 来读取 (如下)
2. 准备数据
2.1 Explore data - understand your data (分析correlation, 画图表)
2.2 Pre-process (clean, integrate, package) :
Clean
Transform (Scaling, feature selection, Dimensionality Reduction)
3. 分析数据 (选分析技术,创建model)
要分析具体是什么问题然后选取对应的分析技术,比如,regression, classification, clustering, graph analytics, association analysis
4. 报告分析结果
报告什么内容,用什么技术 (R, Python 都有很好的画图功能)
5. Action - Turn insight into action
Coursera, Big Data 1, Introduction (week 1/2)的更多相关文章
- Coursera, Big Data 1, Introduction (week 3)
什么是分布式文件系统?为什么需要分布式文件系统? 如果文件系统可以管理用网络连接的很多个存储单元,叫分布式文件系统. 分布式文件系统提供了数据可扩展性,容错性,高并发. 这些是传统文件系统不具有的. ...
- Building Applications with Force.com and VisualForce(Dev401)(十六):Data Management: Introduction to Upsert
Dev401-017:Data Management: Introduction to Upsert Module Objectives1.Define upsert.2.Define externa ...
- Coursera, Big Data 2, Modeling and Management Systems (week 1/2/3)
Introduction to data management 整个coures 2 是讲data management and storage 的,主要内容就是分布式文件系统,HDFS, Redis ...
- Coursera, Big Data 4, Machine Learning With Big Data (week 1/2)
Week 1 Machine Learning with Big Data KNime - GUI based Spark MLlib - inside Spark CRISP-DM Week 2, ...
- Coursera, Big Data 3, Integration and Processing (week 5)
Week 5, Big Data Analytics using Spark Programing in Spark Spark Core: Programming in Spark us ...
- Coursera, Big Data 3, Integration and Processing (week 4)
Week 4 Big Data Precessing Pipeline 上图可以generalize 成下图,也就是Big data pipeline some high level processi ...
- Coursera, Big Data 3, Integration and Processing (week 1/2/3)
This is the 3rd course in big data specification courses. Data model reivew 1, data model 的特点: Struc ...
- Coursera, Big Data 2, Modeling and Management Systems (week 4/5/6)
week4 streaming data format 下面讲 data lakes schema-on-read: 从数据源读取raw data 直接放到 data lake 里,然后再读到mode ...
- Coursera, Big Data 4, Machine Learning With Big Data (week 3/4/5)
week 3 Classification KNN :基本思想是 input value 类似,就可能是同一类的 Decision Tree Naive Bayes Week 4 Evaluating ...
随机推荐
- es6快速入门
上次分享了es6开发环境的搭建,本次接着分享es6常用的特性. 1.变量声明let和const 我们都是知道在ES6以前,var关键字声明变量.无论声明在何处,都会被视为声明在函数的最顶部(不在函数内 ...
- Django 跨域请求
跨域:通过js或python在不同的域之间进行数据传输或通信,比如用ajax向一个不同的域请求数据,或者通过js获取页面中不同域的框架中(Django)的数据.只要协议.域名.端口有任何一个不同,都被 ...
- Fiddler 你需要了解的
官网:http://www.telerik.com/fiddler Fiddler是一个http协议调试代理工具,它能够记录并检查所有你的电脑和互联网之间的HTTP通讯,设置断点,查看所有的“进出”F ...
- PostCSS理解与运用
1.PostCSS是什么 它可以被理解为一个平台,可以让一些插件在上面跑 它提供了一个解析器,可以将CSS解析成抽象语法树 通过PostCSS这个平台,我们能够开发一些插件,来处理CSS.热门插件如a ...
- ELK大流量日志分析系统搭建
1.首先说下EKL到底是什么吧? ELK是Elasticsearch(相当于仓库).Logstash(相当于旷工,挖矿即采集数据).Kibana(将采集的数据展示出来)的简称,这三者是核心套件,但并非 ...
- css 中 position属性
position属性详解 文档流 1.html中的布局方式分为三种: 标准流(顺序布局):因为html中的元素大体可以分为两大类(a:块级元素:div .H1-H6. table表格 有序级无序列表 ...
- Linux 查看进程的线程数
三种方法: 1. 使用top命令,具体用法是 top -H 加上这个选项,top的每一行就不是显示一个进程,而是一个线程. 2. 使用ps命令,具体用法是 ps -xH 这样可以查看所有存在的线程,也 ...
- Mysql+Keepalived双主热备高可用操作记录
我们通常说的双机热备是指两台机器都在运行,但并不是两台机器都同时在提供服务.当提供服务的一台出现故障的时候,另外一台会马上自动接管并且提供服务,而且切换的时间非常短.MySQL双主复制,即互为Mast ...
- Centos 6.8编译安装LNMP环境
Centos 6.8编译安装LNMP环境 参考资料: http://www.jb51.net/article/107429.htm https://phperzh.com/articles/1360 ...
- kettle连接mysql数据库并进行数据分析
1.数据库链接驱动 如果没有安装对应的数据库链接驱动,在数据库链接的过程中,可能会报某个数据库连接找不到的异常,因此需要下载对应驱动后(安装步骤可以参见“怎么在官网上下载java连接mysql的驱动j ...