
Coursera, Big Data 3, Integration and Processing (week 4)
Week 4
Big Data Precessing Pipeline
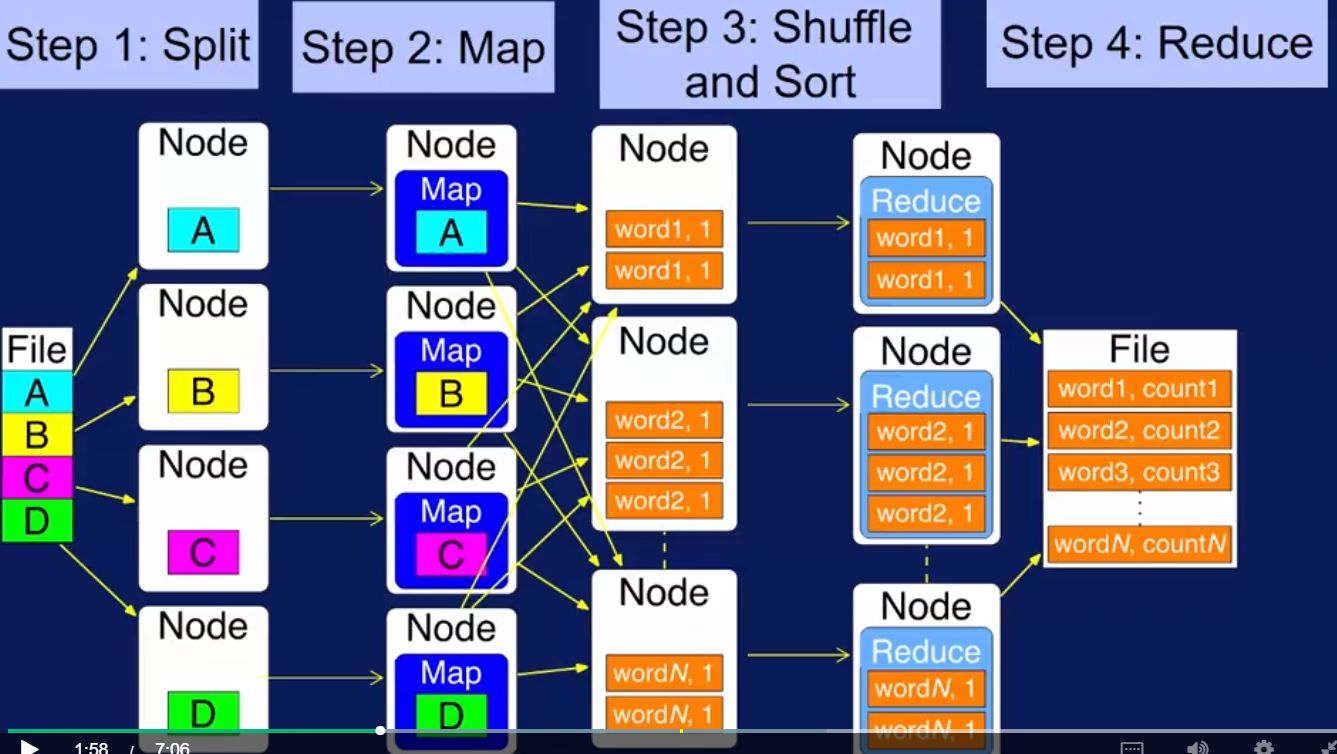
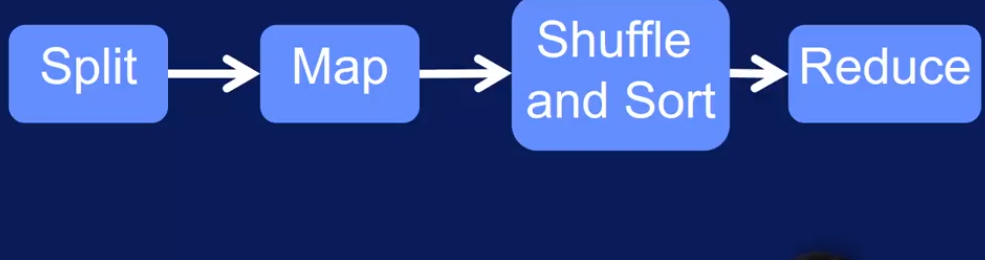
上图可以generalize 成下图,也就是Big data pipeline
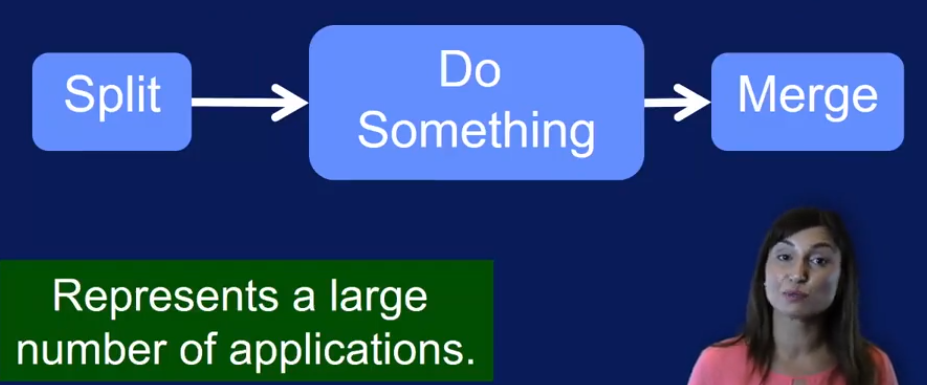
some high level processing operations in big data pipeline
在一个pipeline里 有哪些data transformation 方法?课程上讲了一个类比data transformation的例子,把原木加工成家具.
基本的data transformation 操作有 : Map 是第一个,还有Reduce, Cross/Cartesian, Match/Join, Co-Group, Filter
Aggregation opeartions in big data pipeline
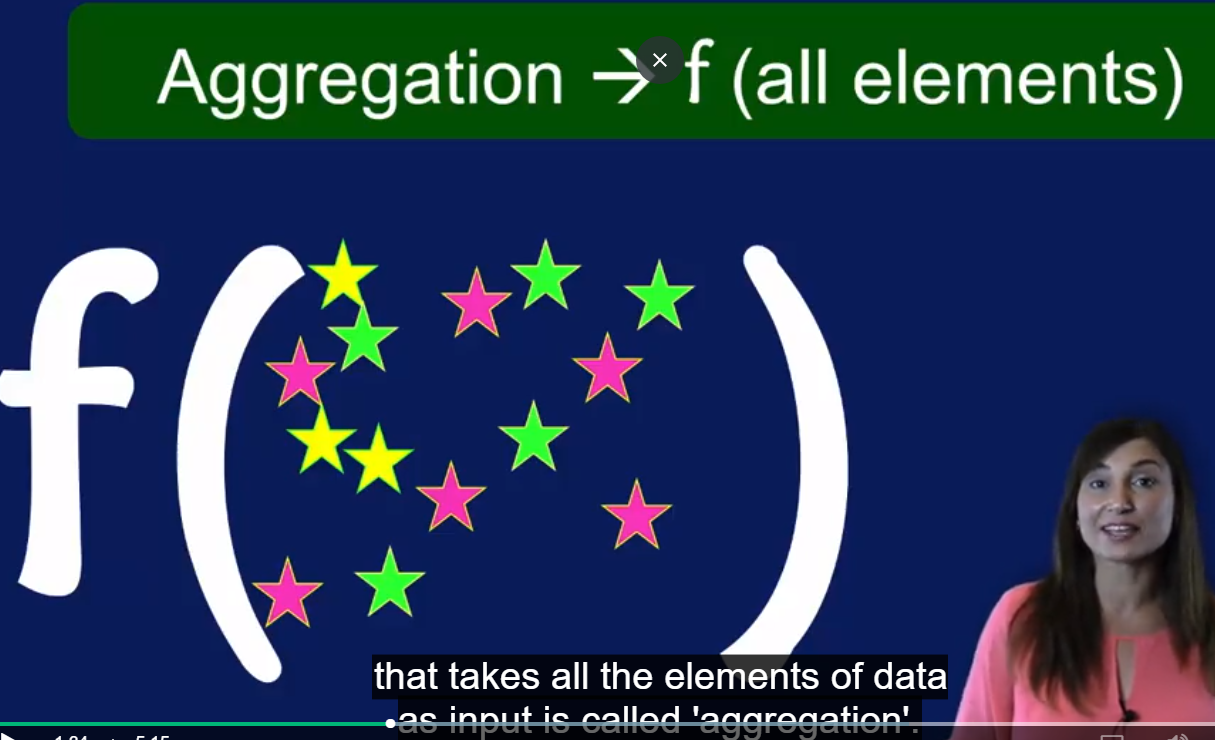
比如上图中,每个星星的值是1,求和就是一个aggregation操作,还有对所有星星按颜色分类也是一个aggression操作。 对全部数据求 sum, avg, max, min, std 都是aggression操作
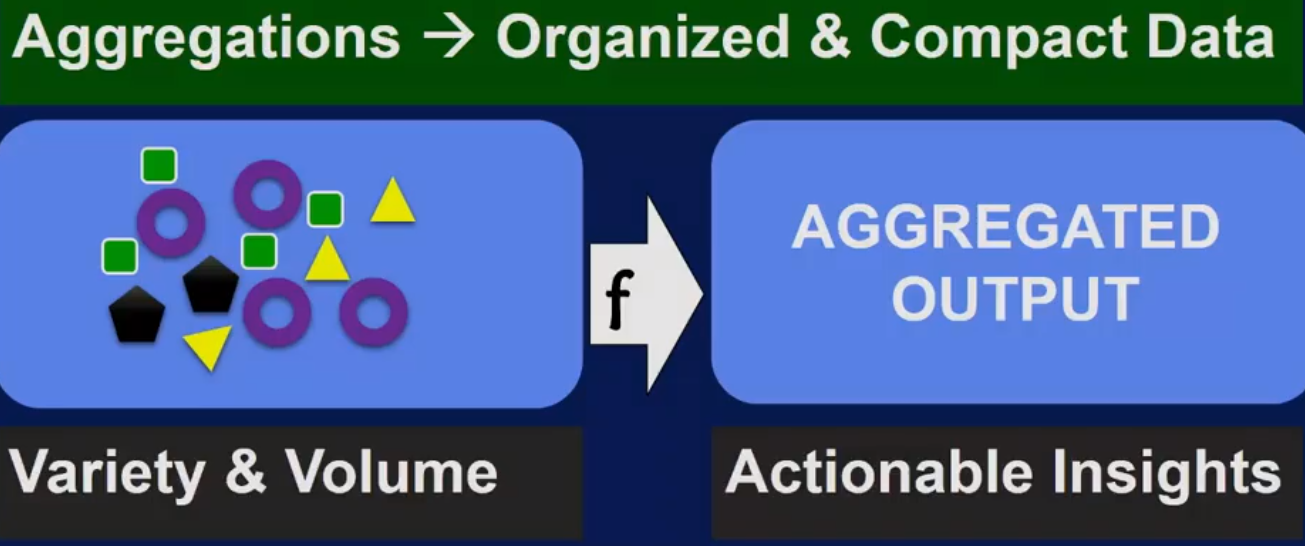
analytical opearations in big data pipeline
Classification - DT
Clustering - K-means
Path analysis - find shortest path from home to work
Connectivity analyasis - graph
Big data processing tool and systems
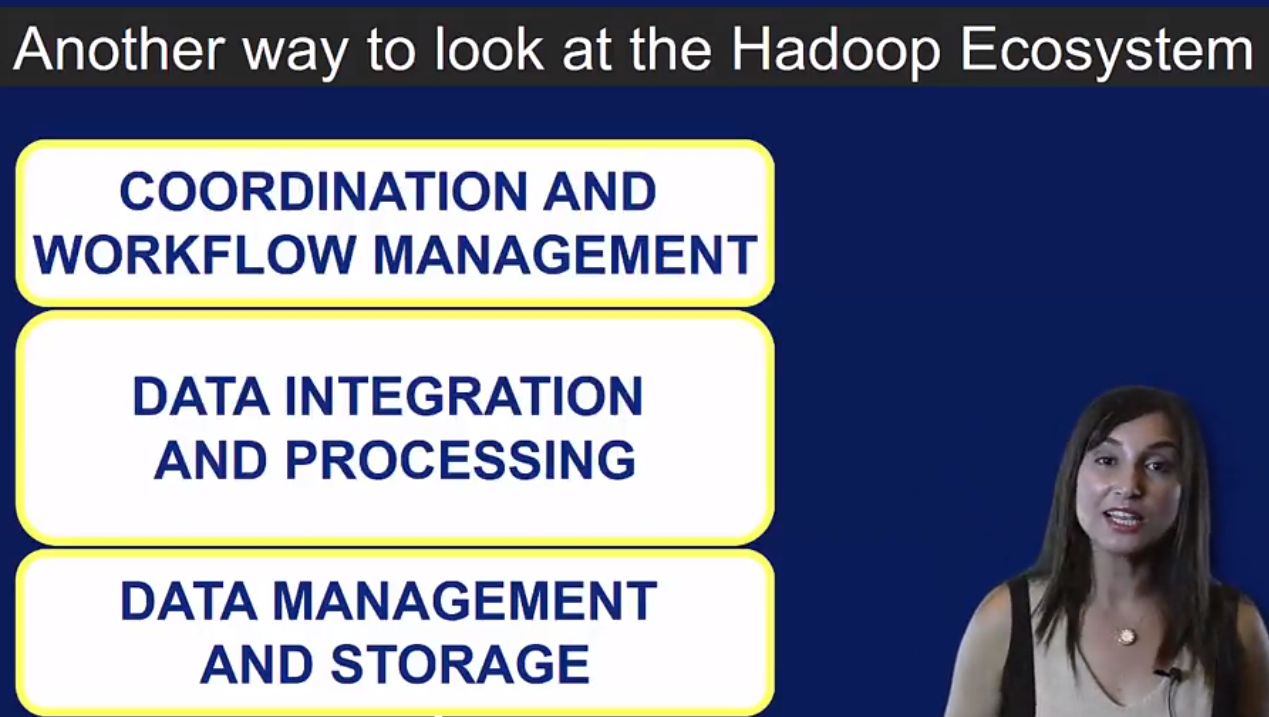
上面是 big data 的3层结构, 系列课程的整个course 2就是讲最底层的 data management and storage 的. 第二层就是这个course 3 主要讲的内容
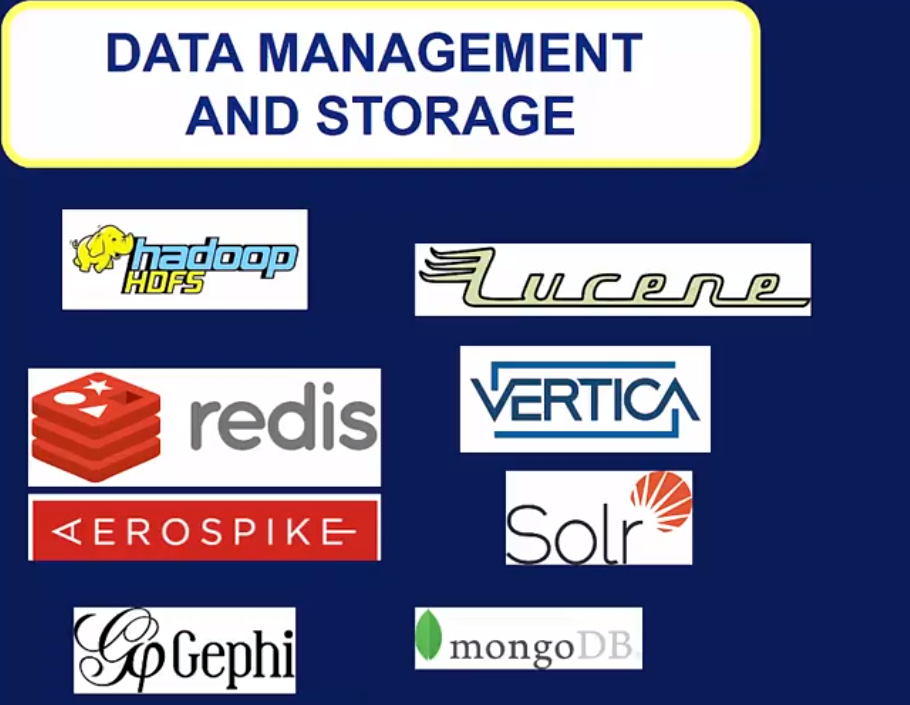
Redis, AeroSpike - key value storage
Lucene
Gephi - vector and graph data storage
Vertica, Cassadra, HBase- column store database
Solr, Asterisk DB - for managing unstrunctured and semi-structured text.
mongodb - document store
下面看第二层
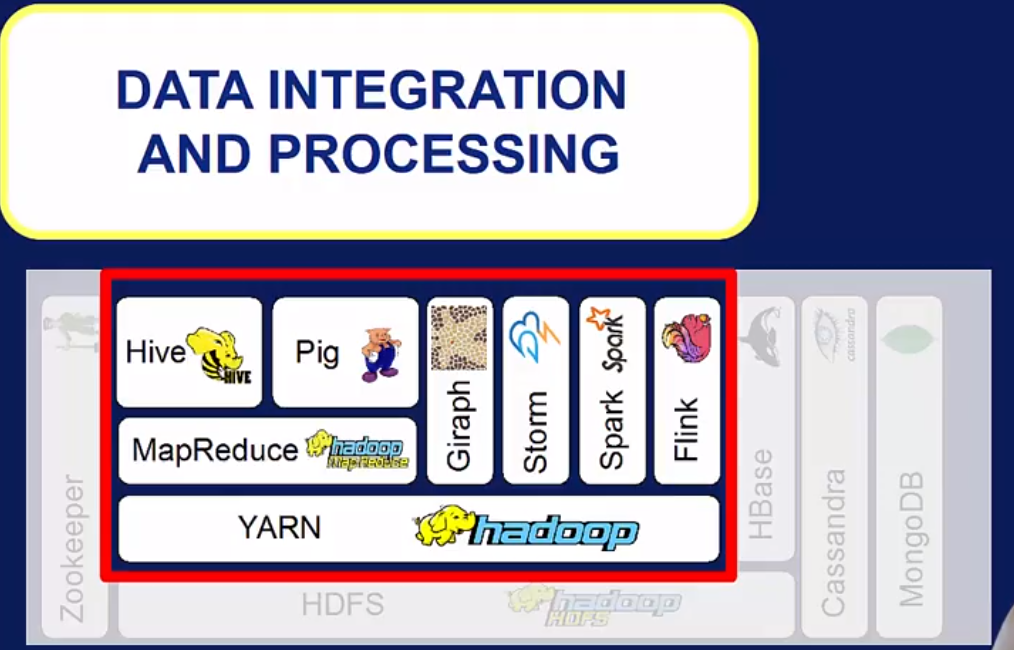
YARN - enabler
Hive, Spark SQL - query interface
Pig - 脚本化使用 Map-Reduce 框架
Giraph, Spark GraphX - graph analytics
Mahout, Spark MLib - machine learning
接下来是第三层
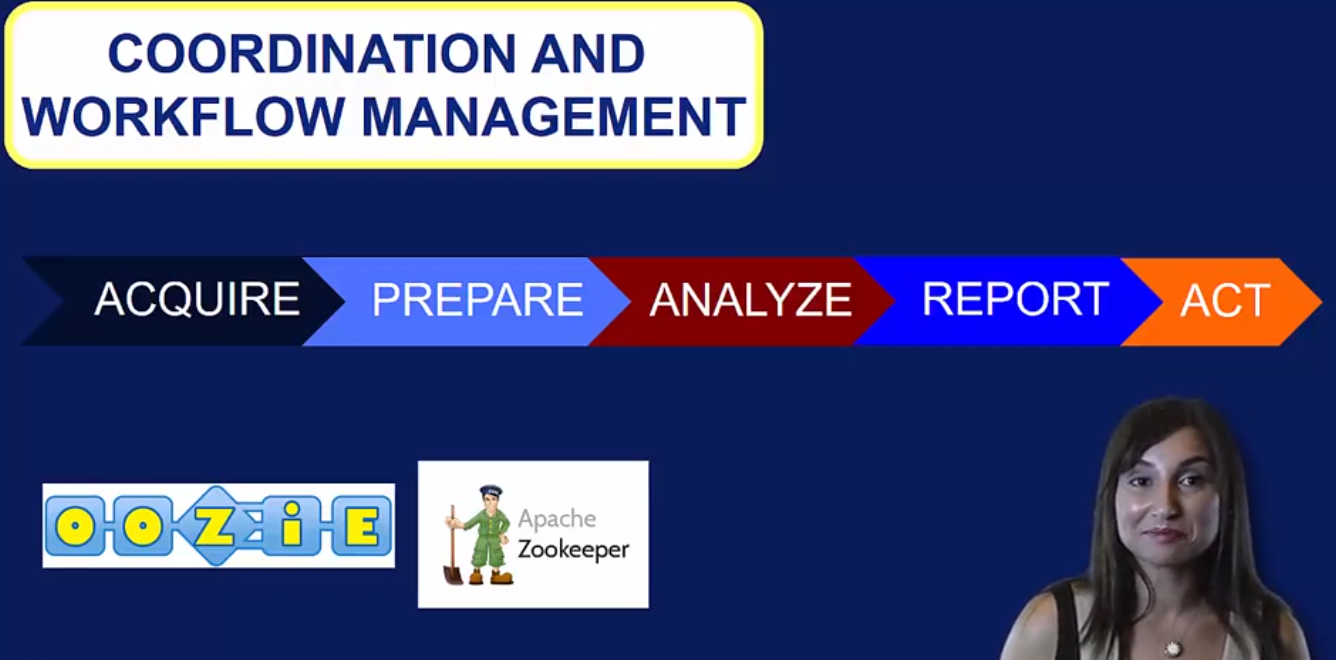
OOZiE - workflow scheduler, 可以和第二层的很多tool 交互
ZooKeeper - Resource coordination and monitoring tool
现在回到第二层,主要讲5个data processing engine
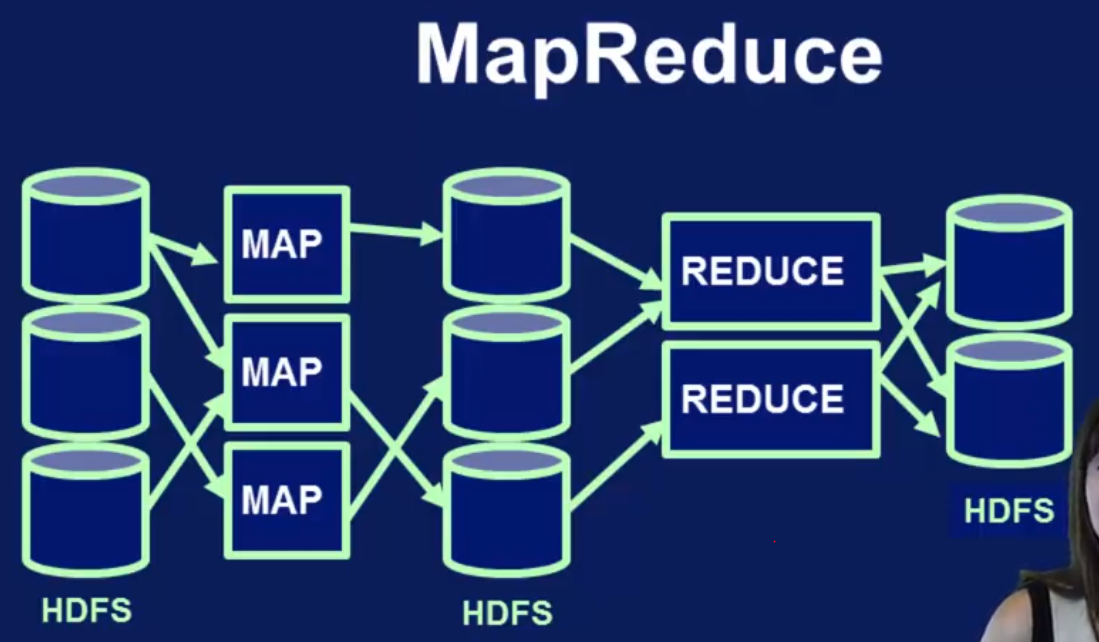
Map-Reduce 从HDFS读数据,没有in-memory 支持,意味着Mapper只能写数据到files然后Reduce去读, 这就导致high letency 和 less scalable. 虽然也有python库但是只有Java可以作为高效编程语言. 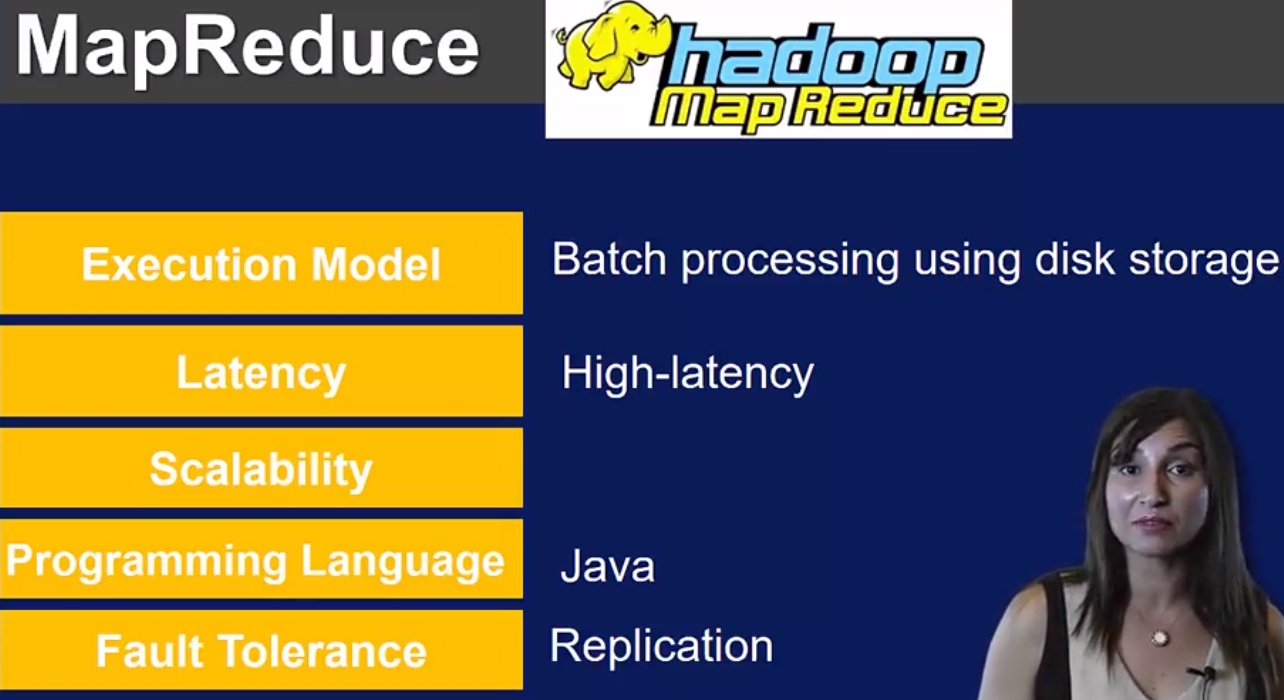
Spark 支持迭代的交互的data processing pipeline. 有in-memory 结构的RDD(Resilient Distributed Datasets)支持, 除了支持 Map, Reduce 还支持Join, Filter 操作. 所有的transformation操作都能放到 RDD里,所有效率很高. 除了能从HDFS读数据,还可以从很多storage platform读数据。可以用micro-batching 技术读取streaming data.
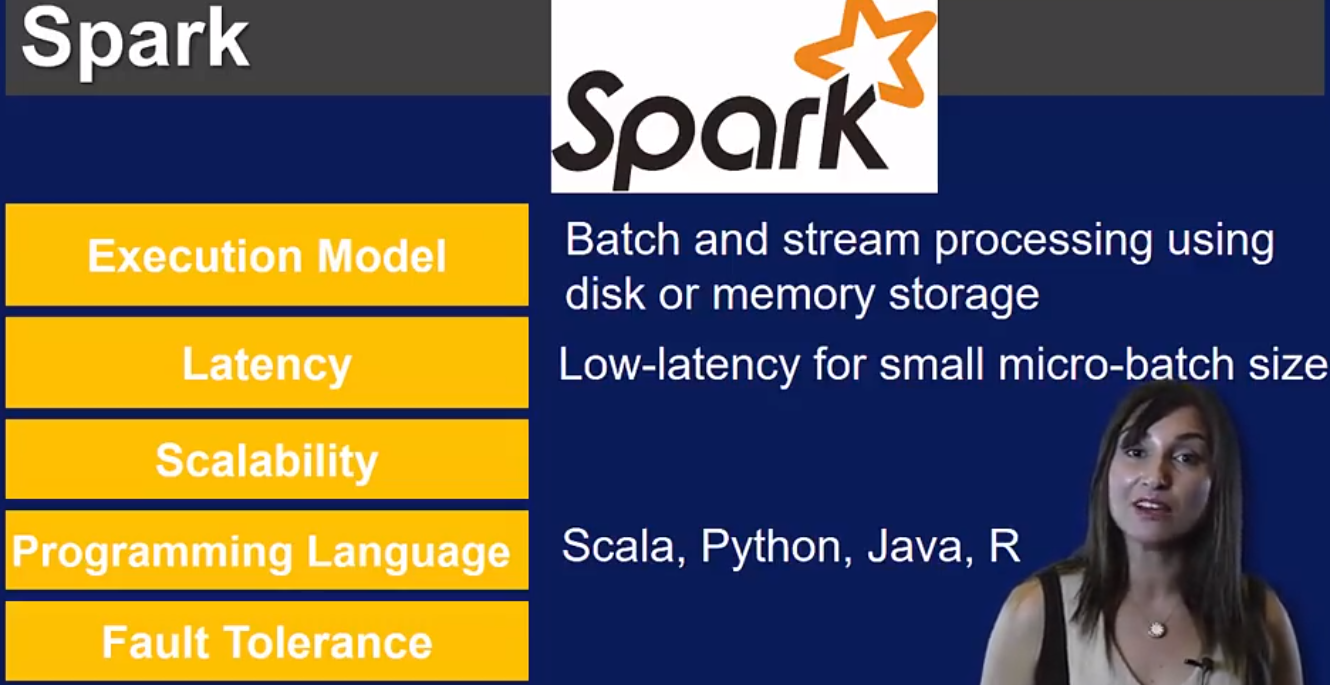
Flink 和Spark 类似,同时提供了连接stream data ingestion engine (比如Kafka, Flume) 的接口. Flink 有自己的 execution engine 叫 Nephele, 它支持在Hadoop上跑,可以在自己的Nephele上跑。 除了支持Map, Reduce, 还支持join, group by. Flink最大的优点是有一个优化器可以自动选择最优模式和实行策略.
Beam, 来自google
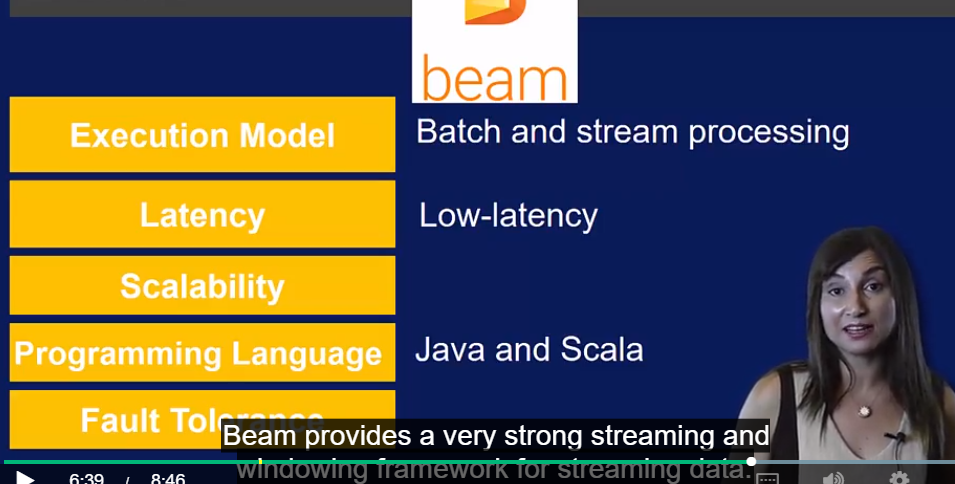
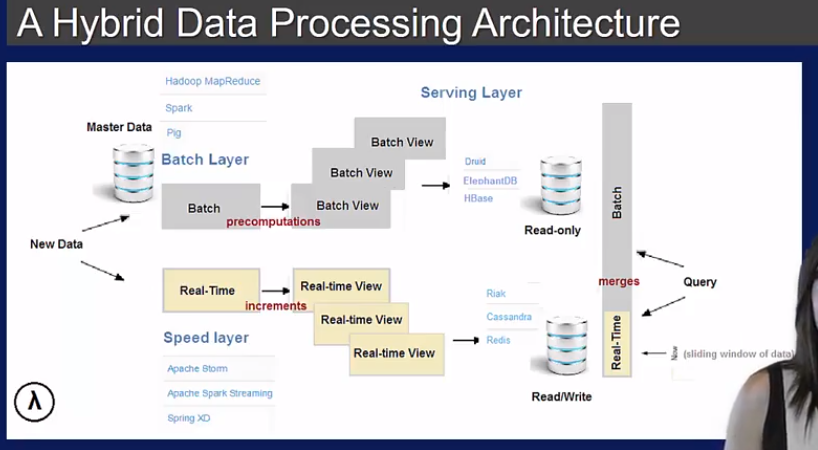
Storm, 提供了输入抽象 spouts 和计算抽象 bolts. Storm 提供了Lambda Architecture, 可以把streaming 处理和 batch 处理分开处理
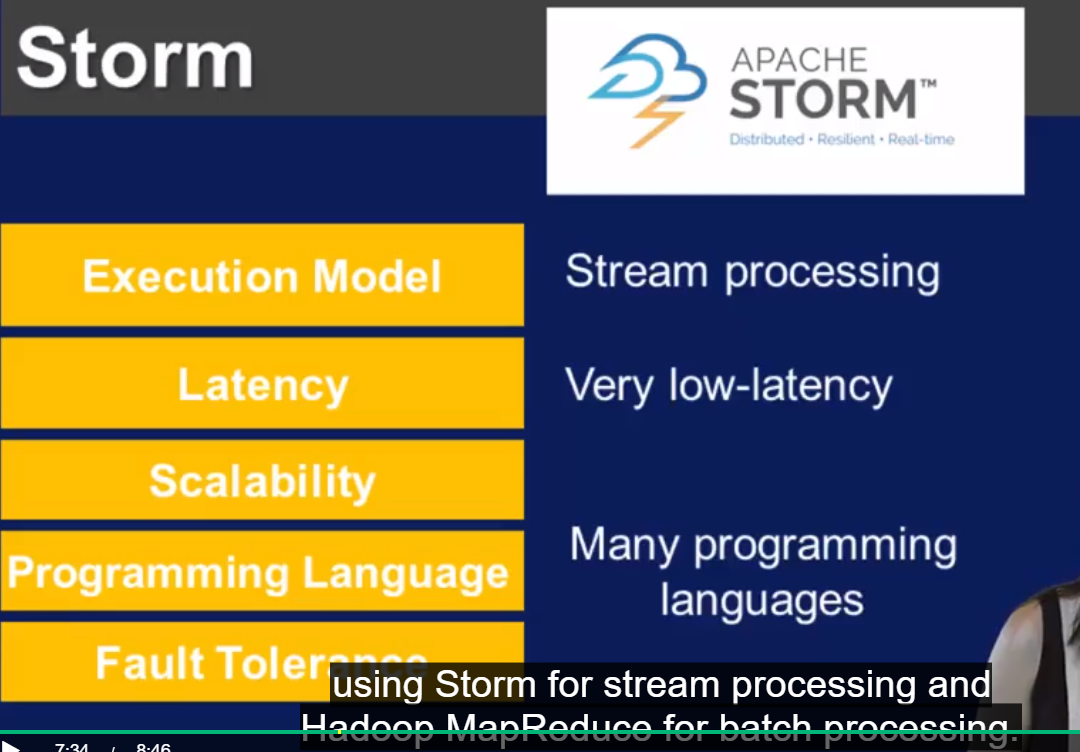
开始版本的Storm 是下面这样的,batch 和 steam 分开处理
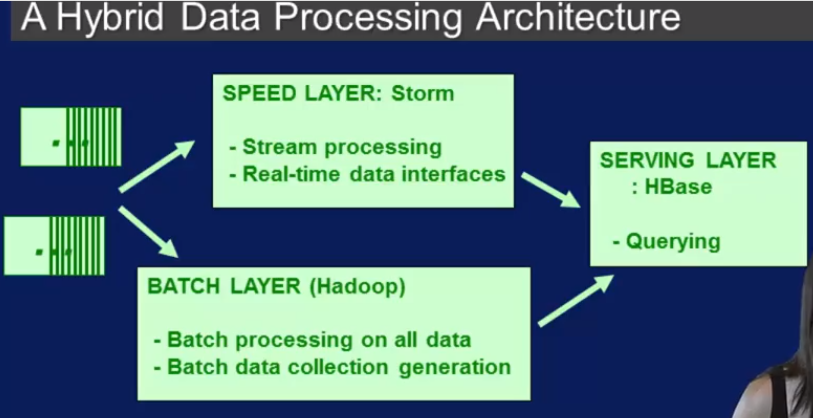
新版本的storm 可以用spark 既处理stream又处理batch.
Dive into Spark
Hadoop 的MapReduce 又弊端,首先它是针对batch processing的,对streaming 不支持,还有它只支持Map 和Reduce两种操作,很多情况下无法满足一个复杂Pipeline的需求
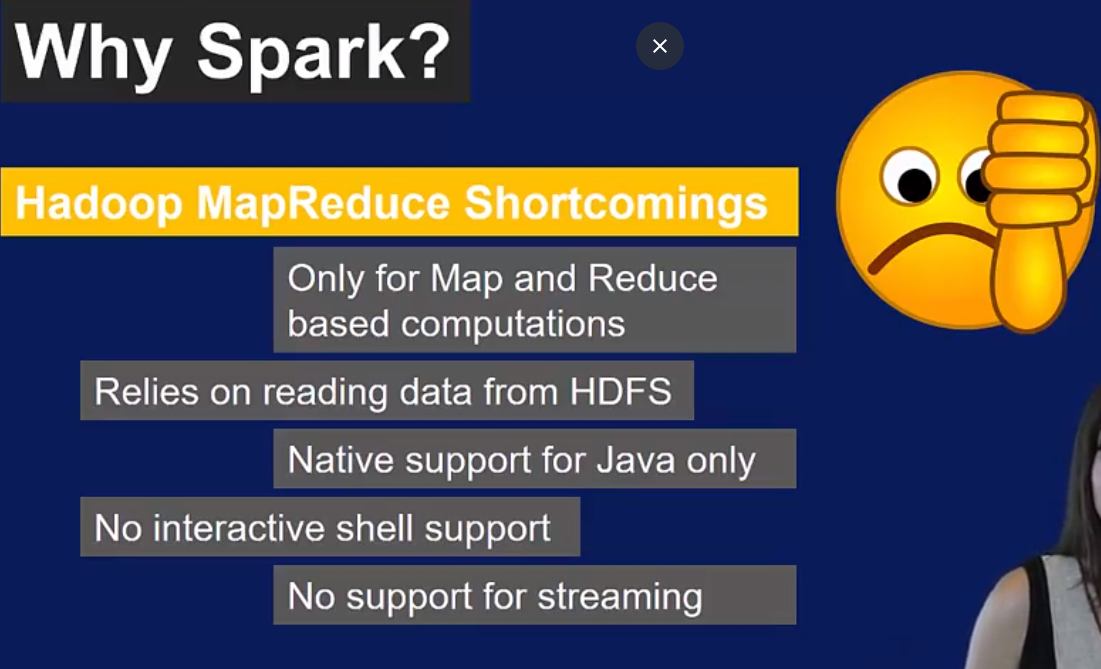
Spark 的优点如下
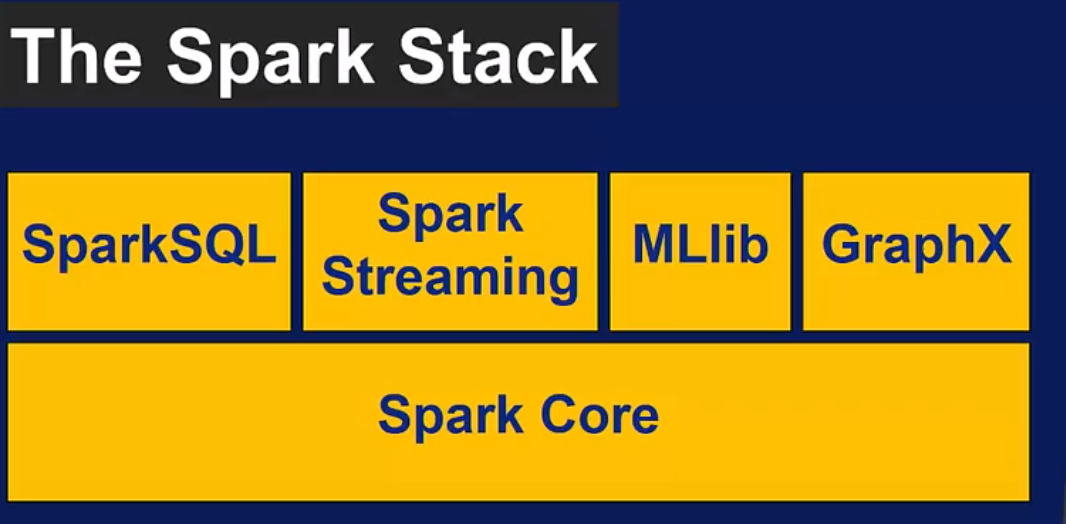
Spark组件建立在Spark计算引擎上, 其中Spark Core 包括支持分布式调度,内存管理,全容错。和像YARN和Mesos 这样的资源调度器,以及像HBase等各种NoSQL数据库交互都是通过Spark Core.Core 非常重要的一个部分是用来定义RDD的APIs.
Spark SQL 可以通过共同的query languange 查询结构化和非结构化数据.
Spark Streaming 对streaming data 做操作的.
MLlib 是机器学习库
GraphX - 图处理分析库
Getting started with Spark
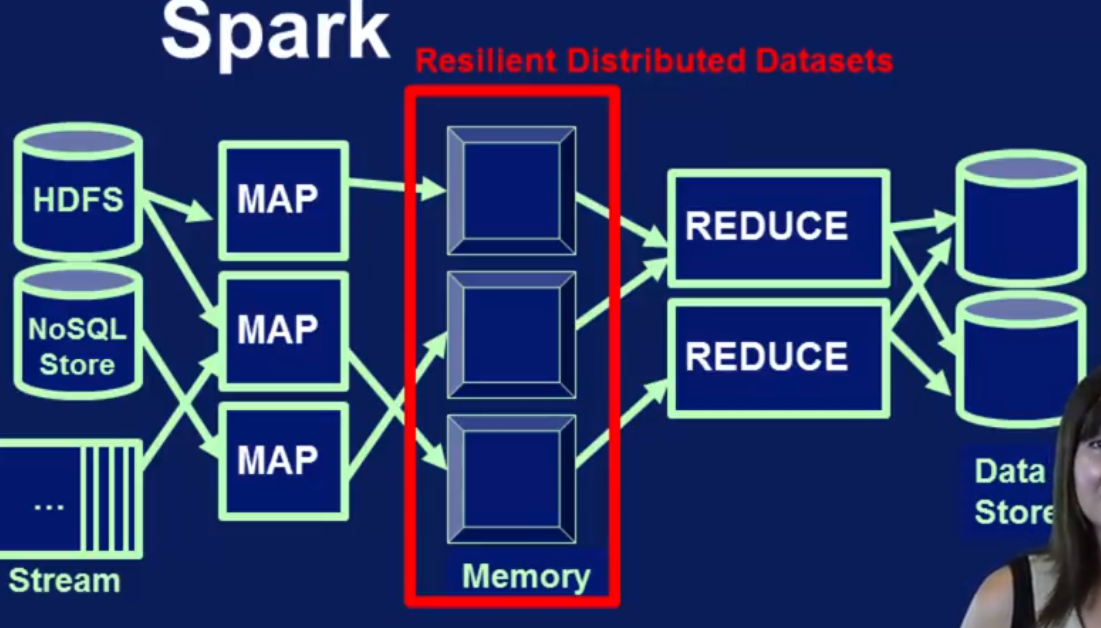
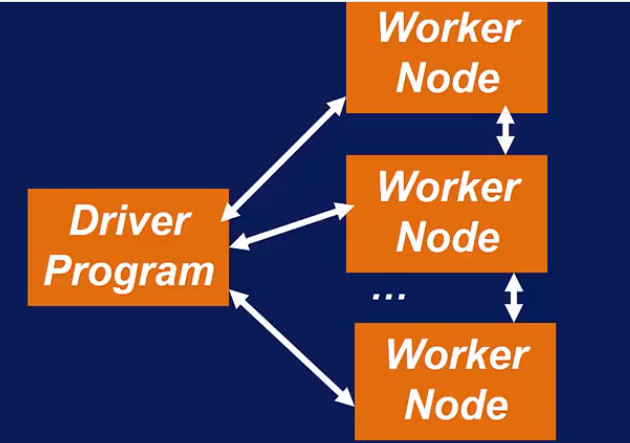
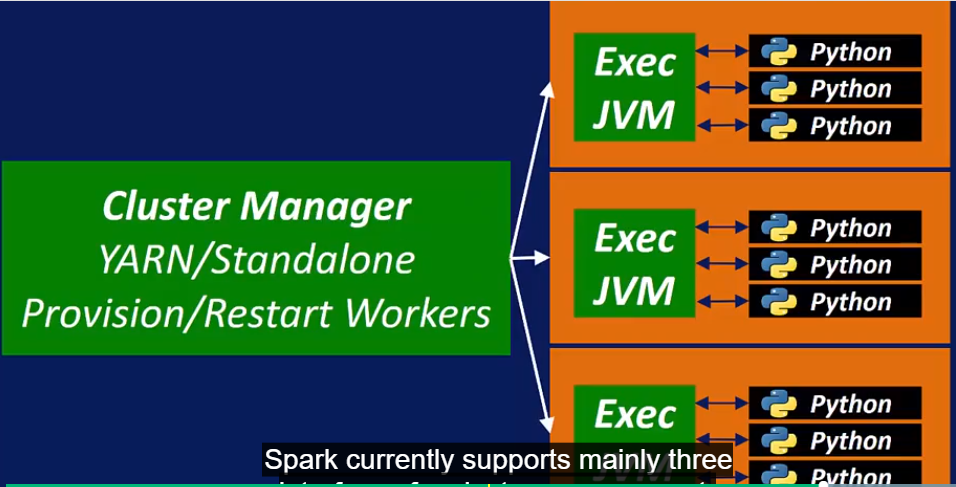
Spark Cluster Manager 支持3种接口: Standalone Cluster Manger, YARN, Mesos.
怎么选 cluster manager, 见下面link.
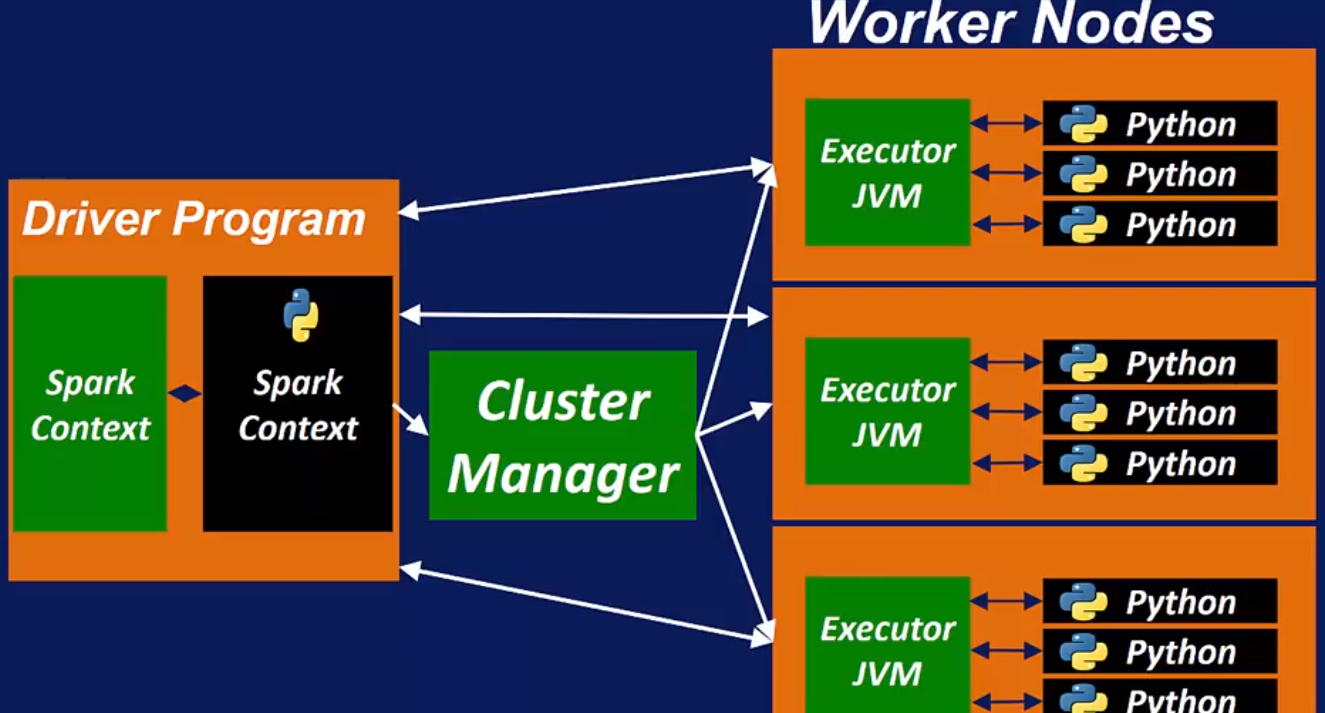
Summary architecure
Terms:
neo4j - graph database, 用来查询的query language 叫 Cypher.
Kafka - stream data ingestion engine
Flume - stream data ingestion engine, collects and aggregates log data
Coursera, Big Data 3, Integration and Processing (week 4)的更多相关文章
- Coursera, Big Data 3, Integration and Processing (week 1/2/3)
This is the 3rd course in big data specification courses. Data model reivew 1, data model 的特点: Struc ...
- Coursera, Big Data 3, Integration and Processing (week 5)
Week 5, Big Data Analytics using Spark Programing in Spark Spark Core: Programming in Spark us ...
- Coursera, Big Data 4, Machine Learning With Big Data (week 1/2)
Week 1 Machine Learning with Big Data KNime - GUI based Spark MLlib - inside Spark CRISP-DM Week 2, ...
- Coursera, Big Data 2, Modeling and Management Systems (week 4/5/6)
week4 streaming data format 下面讲 data lakes schema-on-read: 从数据源读取raw data 直接放到 data lake 里,然后再读到mode ...
- Coursera, Big Data 2, Modeling and Management Systems (week 1/2/3)
Introduction to data management 整个coures 2 是讲data management and storage 的,主要内容就是分布式文件系统,HDFS, Redis ...
- Coursera, Big Data 1, Introduction (week 3)
什么是分布式文件系统?为什么需要分布式文件系统? 如果文件系统可以管理用网络连接的很多个存储单元,叫分布式文件系统. 分布式文件系统提供了数据可扩展性,容错性,高并发. 这些是传统文件系统不具有的. ...
- Coursera, Big Data 1, Introduction (week 1/2)
Status: week 2 done. Week 1, 主要讲了大数据的的来源 - 机器产生的数据,人产生的数据(比如社交软件上的update, 一般是unstructed data), 组织产生的 ...
- Coursera, Big Data 4, Machine Learning With Big Data (week 3/4/5)
week 3 Classification KNN :基本思想是 input value 类似,就可能是同一类的 Decision Tree Naive Bayes Week 4 Evaluating ...
- In-Stream Big Data Processing
http://highlyscalable.wordpress.com/2013/08/20/in-stream-big-data-processing/ Overview In recent y ...
随机推荐
- opn要求
1.在公司 ♦可以通过阿里云的公网ip访问pg 2.不在公司 ♦需要连接VPN才可访问阿里云的公网ip的应用(假定pg),但是特别的应用不在公司也可直接访问(假定gitlab) 思路提示:vpn黑白名 ...
- 跳跳棋[LCA+二分查找]-洛谷1852
传送门 这真是一道神仙题 虽然我猜到了这是一道LCA的题 但是... 第一遍看题,我是怎么也没想到能和树形图扯上关系 并且用上LCA 但其实其实和上一道lightoj上的那道题很类似 只不过那时一道很 ...
- 第十届蓝桥杯省赛JavaB组个人题解
前言 以下的第十届蓝桥杯Java B组省赛的题目题解只是我个人的题解,提供一些解题思路,仅作参考,如有错误,望大家指出,不甚感激,我会及时更改. 试题 A: 组队 ----- 答案:490 [问题描述 ...
- Golang 入门系列(二)学习Go语言需要注意的坑
上一章节我们已经了解了 Go 环境的配置,不了解的,请查看前面的文章 https://www.cnblogs.com/zhangweizhong/p/9459945.html,本章节我们将学习 Go ...
- 二十六、css3改变checkbox复选框的样式
<!DOCTYPE html> <html> <head> <meta charset="UTF-8"> <title> ...
- IPv6绝不仅仅是对IPv4地址长度的增加
众所周知,IPv6 IP地址长度是IPv4 IP地址长度的四倍,是解决IPv4公共网址资源枯竭的最佳技术.的确,IETF在制定IPv6标准时也是基于这一因素考虑的.当时正是90年代初,Web开始出现, ...
- Linux下部署开源版“禅道”项目管理系统
1.开源版安装包下载 [root@iZbp ~]# wget http://dl.cnezsoft.com/zentao/9.0.1/ZenTaoPMS.9.0.1.zbox_64.tar.gz 2. ...
- Linux下的邮件发送
centos 7的邮件发送 1配置文件vim /etc/mail.rc vim /etc/mail.rc 翻到文件尾部添加 set from=xxxxxxxx@163.com smtp=smtp.16 ...
- Saltstack 安装配置详解
下面这篇文章主要介绍另外一个运维自动化工具 Saltstack . 一.简介 Saltstack 比 Puppet 出来晚几年,是基于Python 开发的,也是基于 C/S 架构,服务端 master ...
- hdu-5786(补图最短路)
题意:给你n个点,m条无向边,问你这n个点构成的完全图,不用那m条边,由一个s出现的单源最短路 解题思路:首先,暴力建图不行,点太多,那么我们就按照它的规则来,把m条边建好,但是建的这个图表示不走的方 ...