
Coursera, Big Data 1, Introduction (week 3)
什么是分布式文件系统?为什么需要分布式文件系统?
如果文件系统可以管理用网络连接的很多个存储单元,叫分布式文件系统. 分布式文件系统提供了数据可扩展性,容错性,高并发. 这些是传统文件系统不具有的.
Hadoop getting started
为什么用Hadoop? Hadoop 的 4 个What 和 How.
Hadoop 的主要Goal:
1. 可扩展来增加 node
2. 容错,Node down 可以很容易recover
3. 可以读取各种格式的数据(structured, unstructured)
4. 把task 分配到不同node,具有并行计算能力
Hadoop 生态系统:
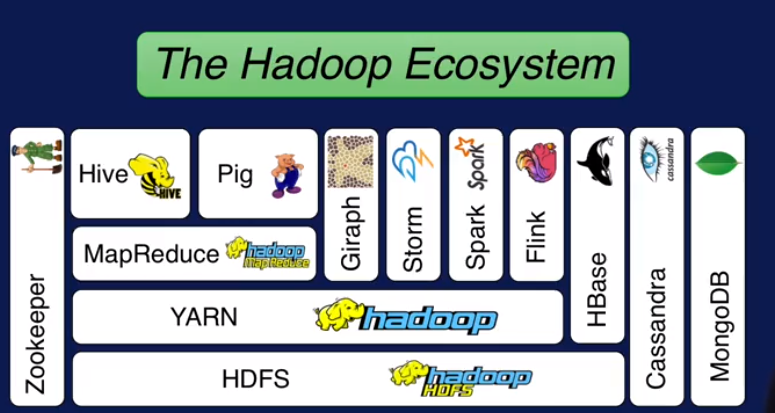
接下来先将整个Hadoop 生态系统,然后讲主要模块(HDFS分布式存储, YARN提供调度和资源管理, MapReduce并行计算) ,最后讲云计算(IaaS, PaaS, SaaS), 此外还有什么时候不适用 Hadoop.
Hadoop生态系统:
前面已经提到了HDFS 是管理分布式存储的, YARN 是负责调度和管理资源的,MapReduce 是做分布式计算的,用户只需要写两个函数就可以实现分布式计算了.
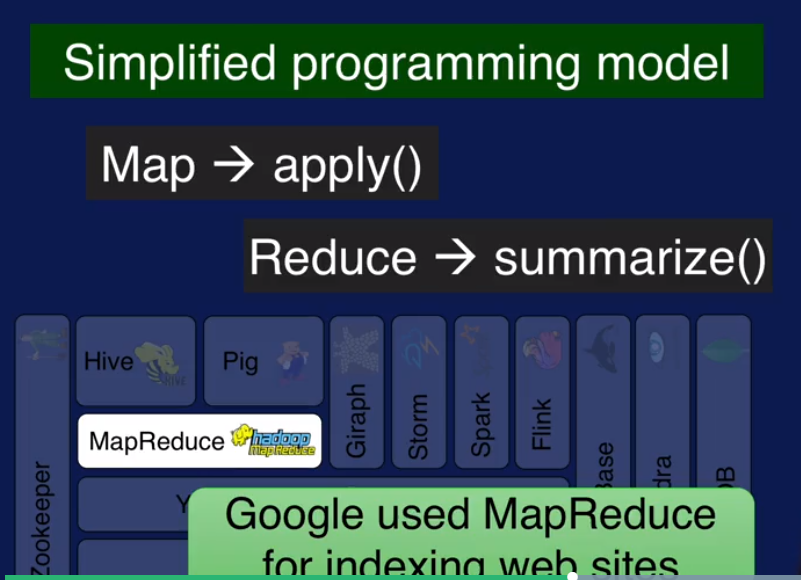
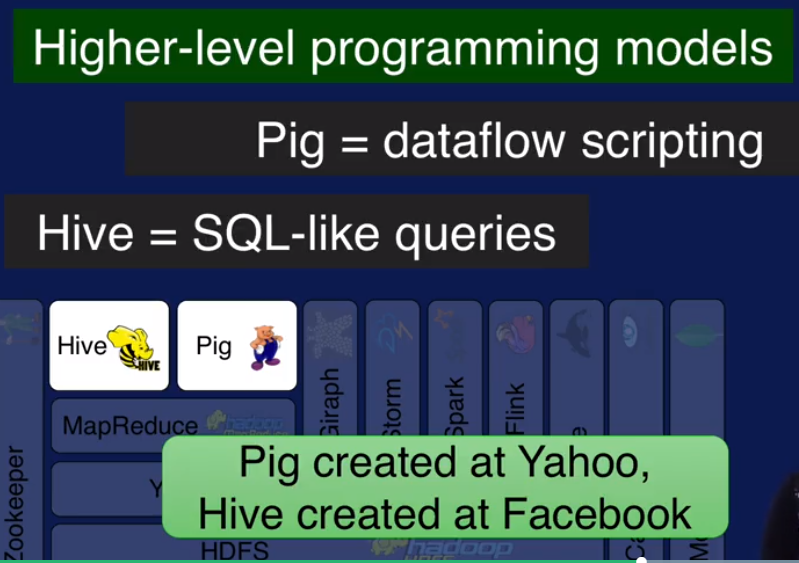
MapReduce 支持的数据model 有限,Hive 和 Pig 是分别针对 SQL-Like query 和 dataflow 类型数据的,可以理解为对MapReduce的扩展.
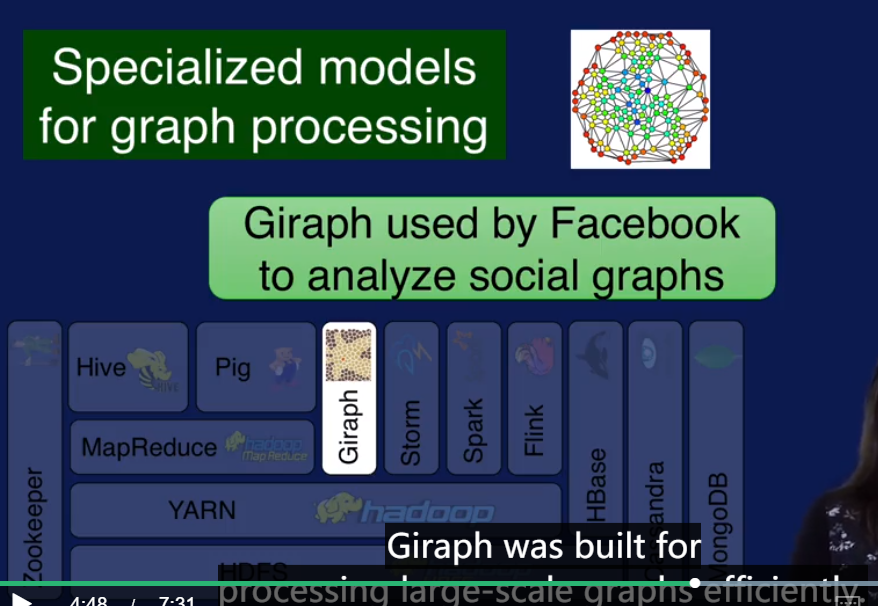
Giraph 用来处理大规模图表.
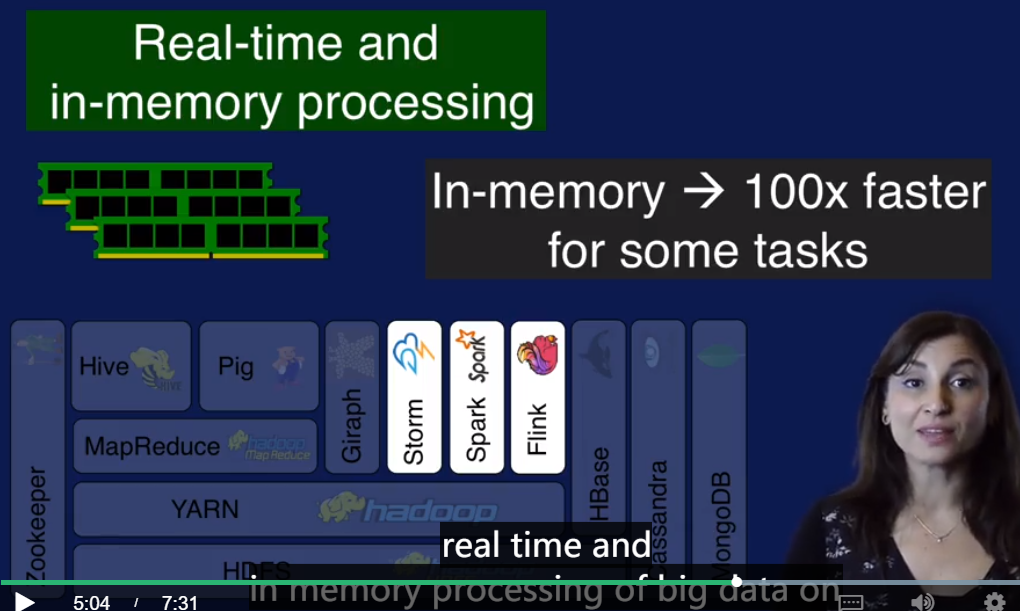
Storm, Spark, Flink 是内存处理大数据的技术.
Strom for streaming data analysis. Spark for in-memory data analysis.
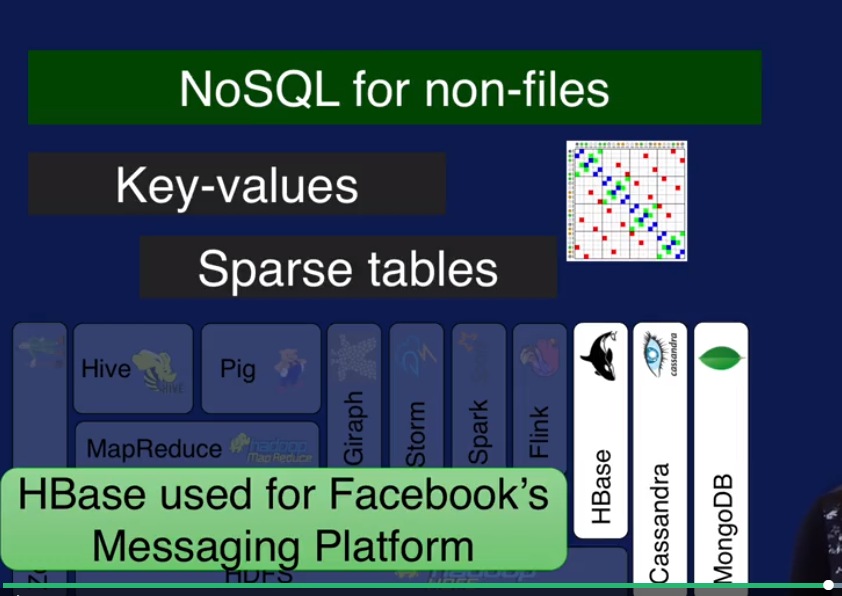
HBase, Cassandra, MongoDB 来处理一些不适合放在关系型数据库的数据,比如 key-value 数据,Sparse tables 数据. 这些都属于 NoSQL 数据库.
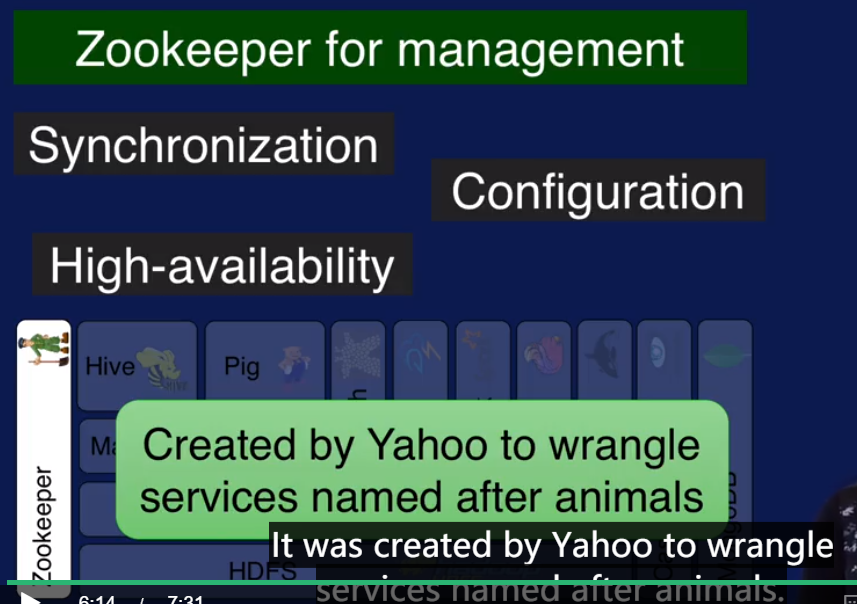
有了上面介绍的这么多模块,需要一个统一的集中管理工具来管理,就是Zookeeper.
这么多工具,如果自己来安排配置其实挺麻烦的,所有就有一些公司提供了集成的预装好的core工具集合,并对production env提供Support. 比如 Cloudera, MAPR, Hortonworks.
讲完了整个生态系统,接下来分别讲模块.
HDFS:
HDFS 怎么提供扩张性和可靠性? 以及它的两个关键模块 NameNode 和 DataNode.
HDFS 默认每一块数据放三份拷贝来提供可靠性. HDFS支持多种数据类型, 读和写时都需要提供数据类型.
HDFS由两种node 组成, Name Node (一般一个cluster就一个)和 Data Node (每个machine都是一个 data node).
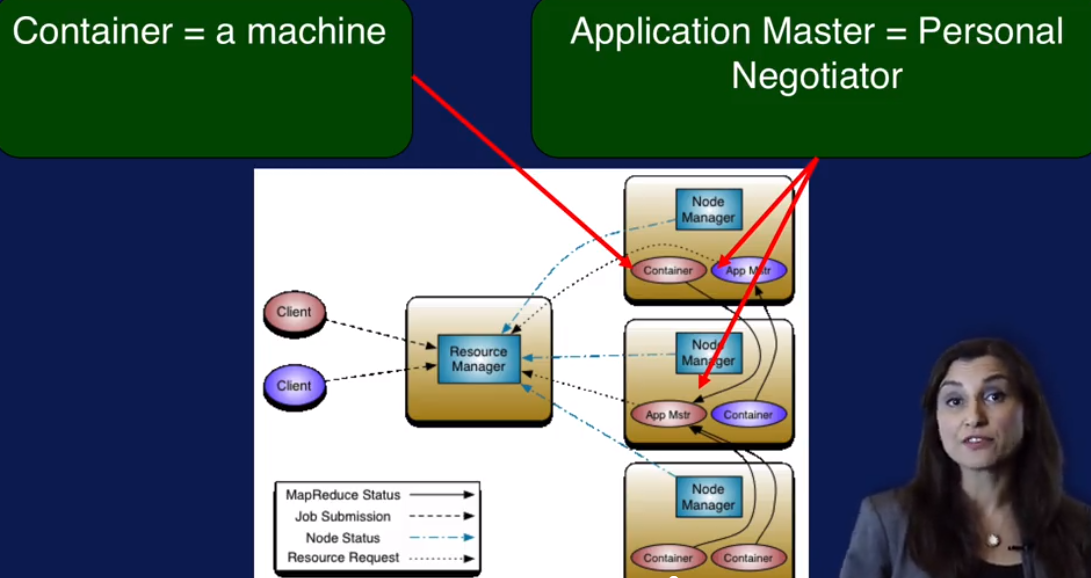
YARN: Resource manager for Hadoop
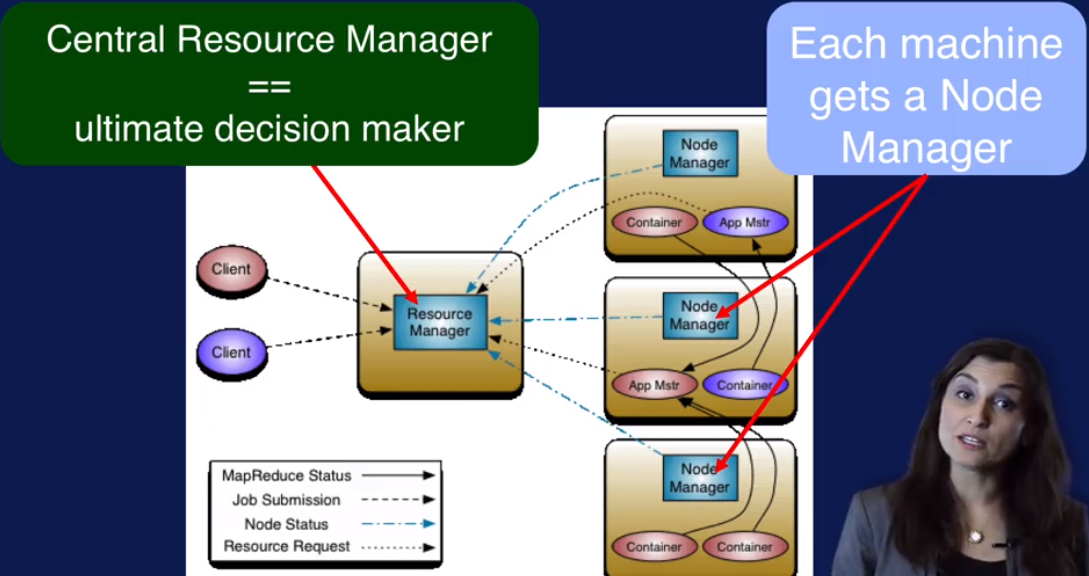
1. Resource manager and node manager
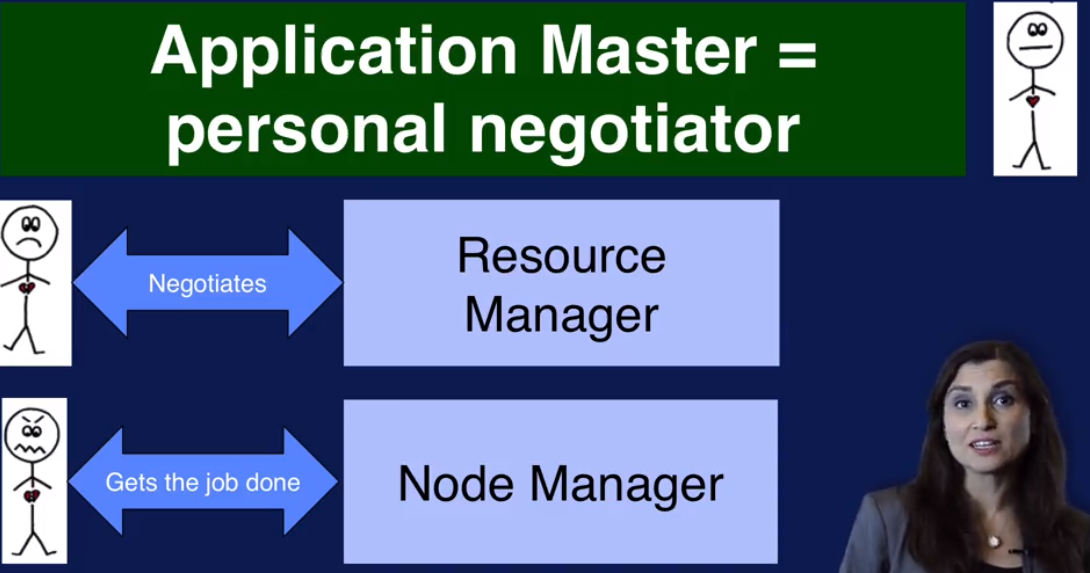
2. Appliacation Master 就像一个谈判人员, 从resource manager 协调资源,让node manager 来负责执行。
3. Container: 可以把它看做资源的抽象.
MapReduce:
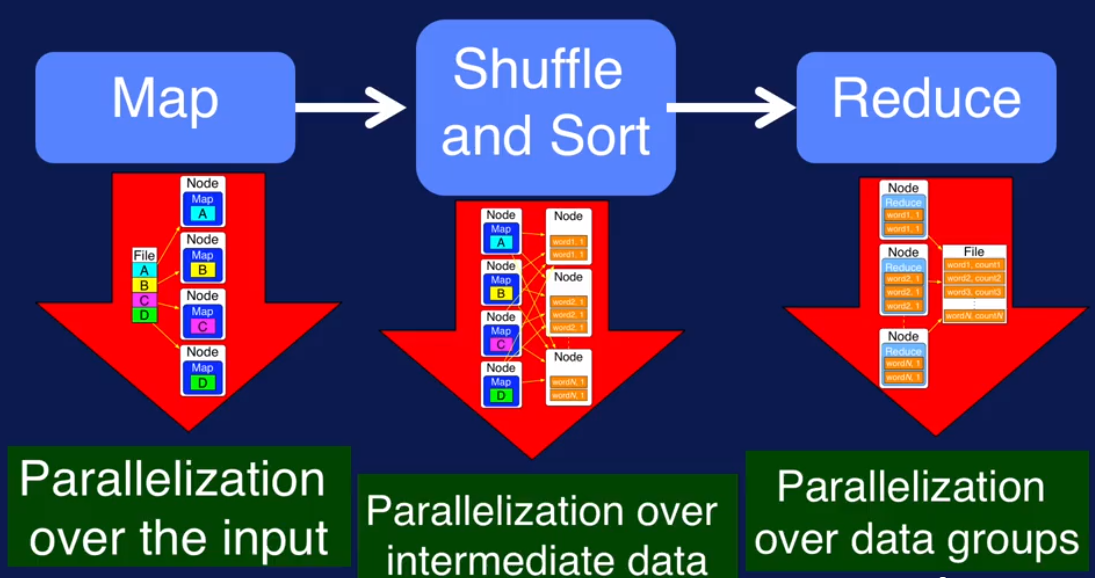
计算分三步:Map -> Shuffle and Sort -> Reduce
下面图片用了WordCount 例子来显示这三个步骤
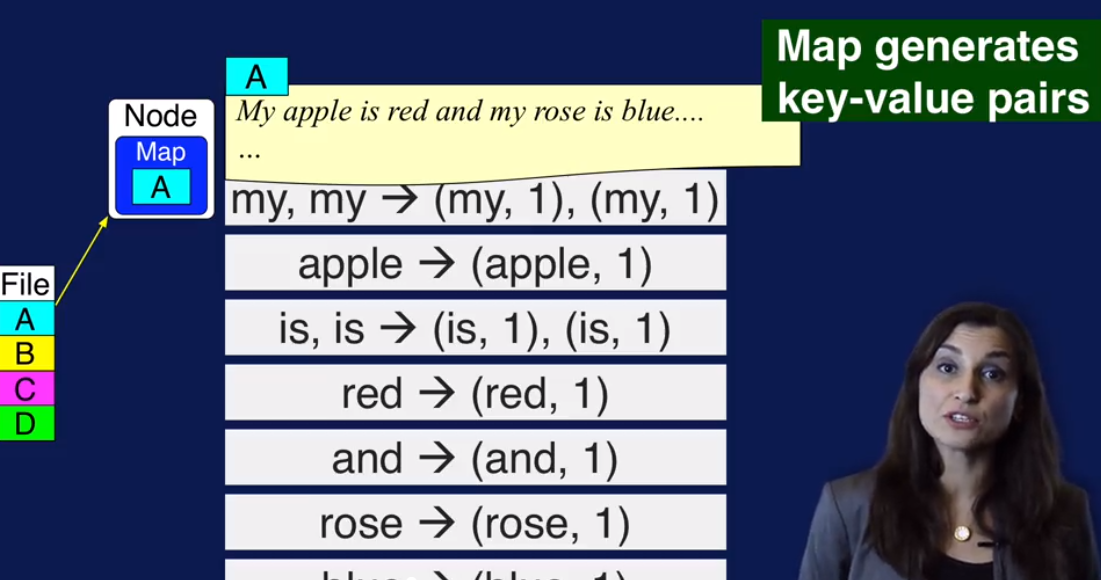
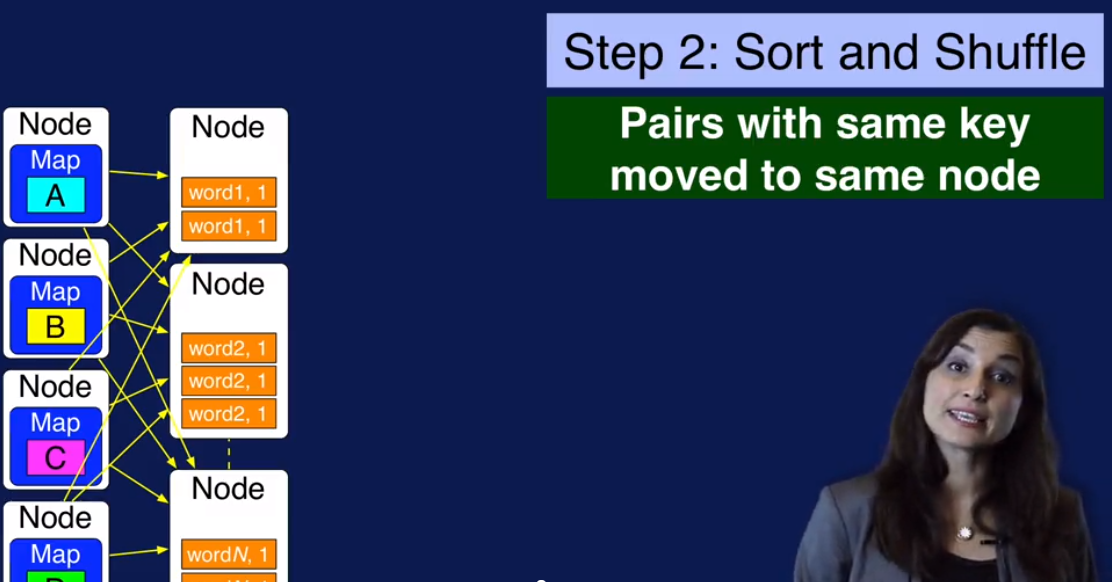
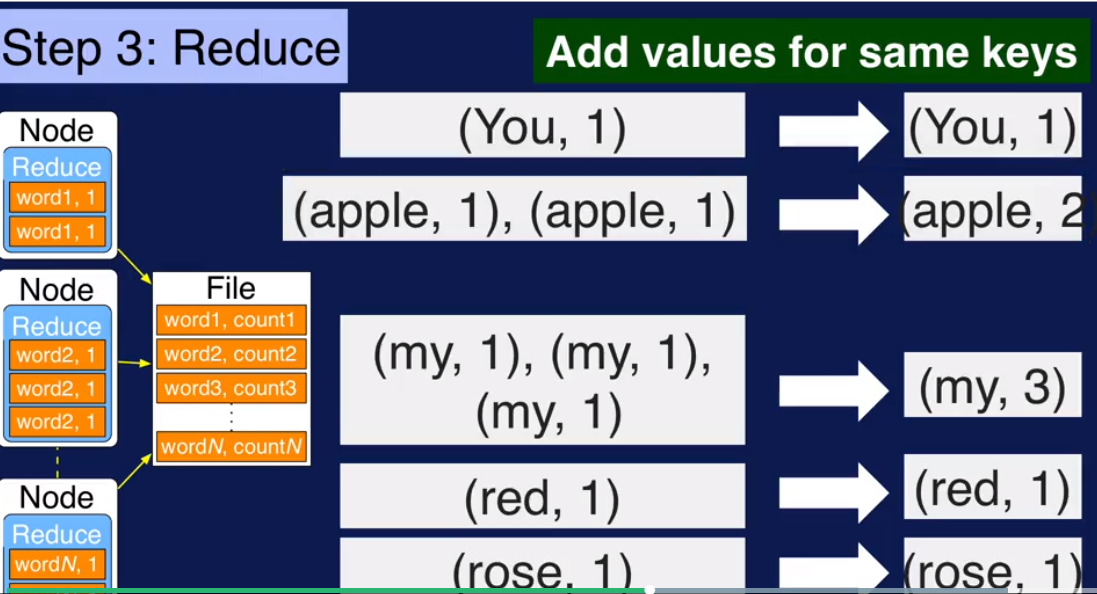
全局图
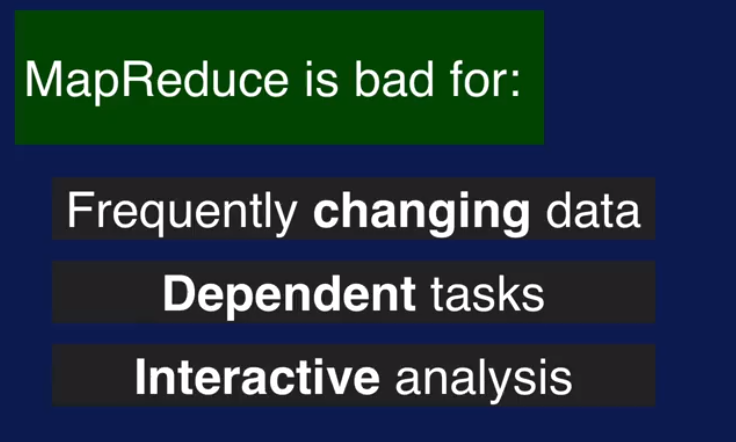
哪些情况不适合使用MapReduce: 因为每次都需要读取Input数据,所有Input数据不能随时变化,还有task 不能有先后依赖,还有MR 算完了才出结果也就不适合交互型的task.
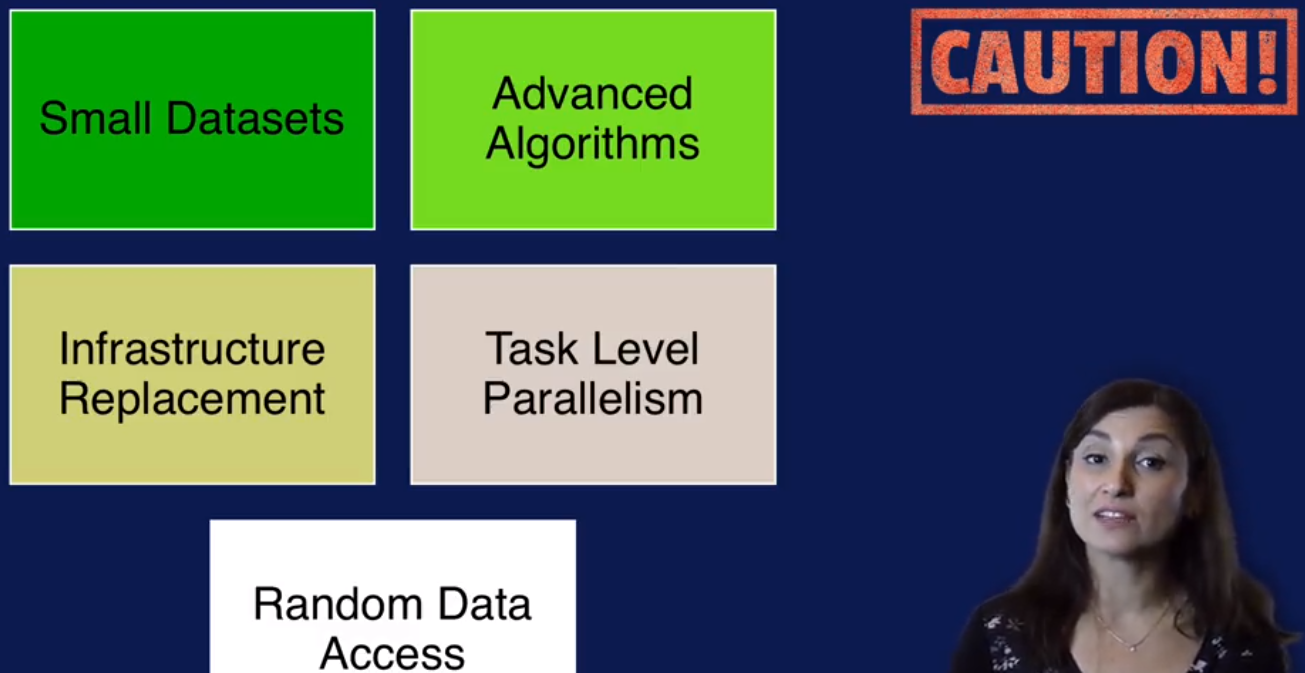
什么情况下Hadoop使用或者不适用?
适用的场景包括了数据量比较大,数据格式多样等
不适用的场景:小数据量;一些数据之间有依赖的高级算法也不适用
云计算:
把基础架构交给云服务商,团队只需要关注应用.
IaaS: 比如 Amazon EC2, 阿里云
PaaS: Microsoft Azure, Google App Engine
SaaS: Dropbox
Value from Hadoop:
Coursera, Big Data 1, Introduction (week 3)的更多相关文章
- Coursera, Big Data 1, Introduction (week 1/2)
Status: week 2 done. Week 1, 主要讲了大数据的的来源 - 机器产生的数据,人产生的数据(比如社交软件上的update, 一般是unstructed data), 组织产生的 ...
- Building Applications with Force.com and VisualForce(Dev401)(十六):Data Management: Introduction to Upsert
Dev401-017:Data Management: Introduction to Upsert Module Objectives1.Define upsert.2.Define externa ...
- Coursera, Big Data 2, Modeling and Management Systems (week 1/2/3)
Introduction to data management 整个coures 2 是讲data management and storage 的,主要内容就是分布式文件系统,HDFS, Redis ...
- Coursera, Big Data 4, Machine Learning With Big Data (week 1/2)
Week 1 Machine Learning with Big Data KNime - GUI based Spark MLlib - inside Spark CRISP-DM Week 2, ...
- Coursera, Big Data 3, Integration and Processing (week 5)
Week 5, Big Data Analytics using Spark Programing in Spark Spark Core: Programming in Spark us ...
- Coursera, Big Data 3, Integration and Processing (week 4)
Week 4 Big Data Precessing Pipeline 上图可以generalize 成下图,也就是Big data pipeline some high level processi ...
- Coursera, Big Data 3, Integration and Processing (week 1/2/3)
This is the 3rd course in big data specification courses. Data model reivew 1, data model 的特点: Struc ...
- Coursera, Big Data 2, Modeling and Management Systems (week 4/5/6)
week4 streaming data format 下面讲 data lakes schema-on-read: 从数据源读取raw data 直接放到 data lake 里,然后再读到mode ...
- Coursera, Big Data 4, Machine Learning With Big Data (week 3/4/5)
week 3 Classification KNN :基本思想是 input value 类似,就可能是同一类的 Decision Tree Naive Bayes Week 4 Evaluating ...
随机推荐
- TableExistsException: hbase:namespace
解决:zookeeper还保留着上一次的Hbase设置,所以造成了冲突.删除zookeeper信息,重启之后就没问题了 1.切换到zookeeper的bin目录: 2.执行$sh zkCli.sh 输 ...
- Failed to start /etc/rc.d/rc.local Compatibility
查看/var/log/message Jun :: root systemd: Started Network Manager. Jun :: root systemd: Starting LSB: ...
- Configuring Apache Kafka Security
This topic describes additional steps you can take to ensure the safety and integrity of your data s ...
- springboot aop + logback + 统一异常处理 打印日志
1.src/resources路径下新建logback.xml 控制台彩色日志打印 info日志和异常日志分不同文件存储 每天自动生成日志 结合myibatis方便日志打印(debug模式) < ...
- java 项目打jar包,用cmd运行,并且编写运行脚本
项目是ideal编辑器的springboot项目的demo.打包就是在侧边栏,点击packge ,就会在target下生成jar包. 生成之后把 jar包放在一个文件夹中.新建一个txt文件,在txt ...
- ideal中把项目打成war包,并放在tomcat运行,遇见的问题。。。
先说下我遇见的问题吧:最近做项目要把项目放在tomcat上运行,用的springboot框架, 在建项目时选择的是 jar包,项目写完要部署打包是,在pom中虽然把包改成了war ,可是每次放入to ...
- SP11470 TTM - To the moon
嘟嘟嘟 主席树+区间修改. 以为是水题,写着写着发现区间修改标记下传会出问题,然后想了想发现以前做的只是单点修改. 那怎么办咧? 然后题解交了我标记永久化这个神奇的东西. 特别好理解,就是修改的时候直 ...
- linux用户身份和文件权限
1.用户身份与能力 root管理员是linux 的超级用户,他拥有系统的所有权,能够管理系统的各项功能,如添加/删除用户,启动/关闭服务进程,开启/禁用硬件设备…… "Linux系统中的管理 ...
- Jetson TX2(1)ubutu1604--安装Nvidia Linux驱动
https://www.jianshu.com/p/c8ebe4aaa708 系统开机首次进入的是以nvidia用户登录的Ubuntu 命令行界面.Nvidia 驱动安装 通过sudo su 输入密码 ...
- 数据规范化——sklearn.preprocessing
sklearn实现---归类为5大类 sklearn.preprocessing.scale()(最常用,易受异常值影响) sklearn.preprocessing.StandardScaler() ...