
Coursera, Big Data 2, Modeling and Management Systems (week 4/5/6)
week4
streaming data format
下面讲 data lakes
schema-on-read: 从数据源读取raw data 直接放到 data lake 里,然后再读到model里
schema-on-write: 传统模式,把raw data 经过处理后放到data warehouse里,此时已经是结构化的数据,然后直接load 出来
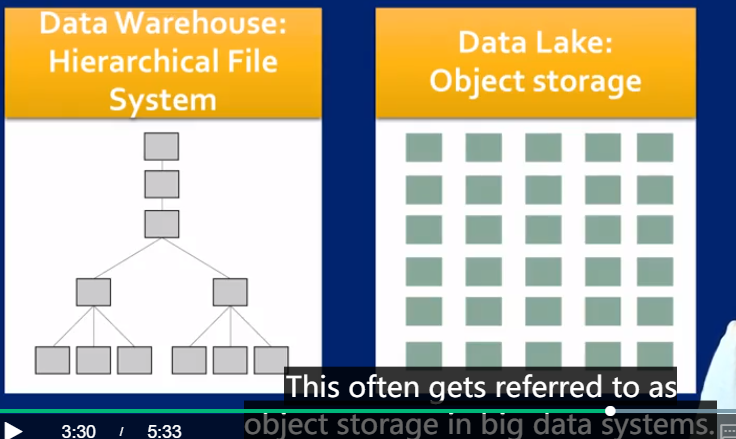
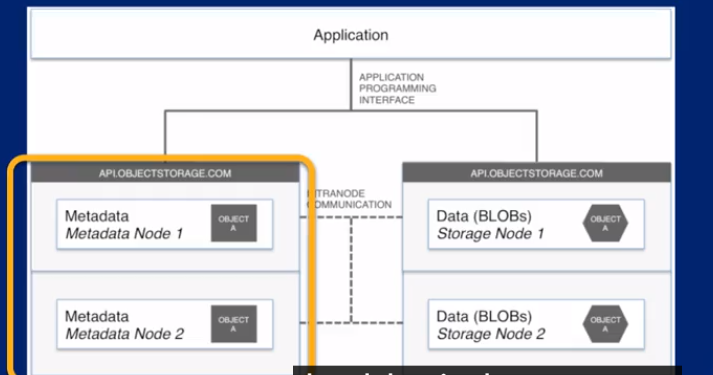
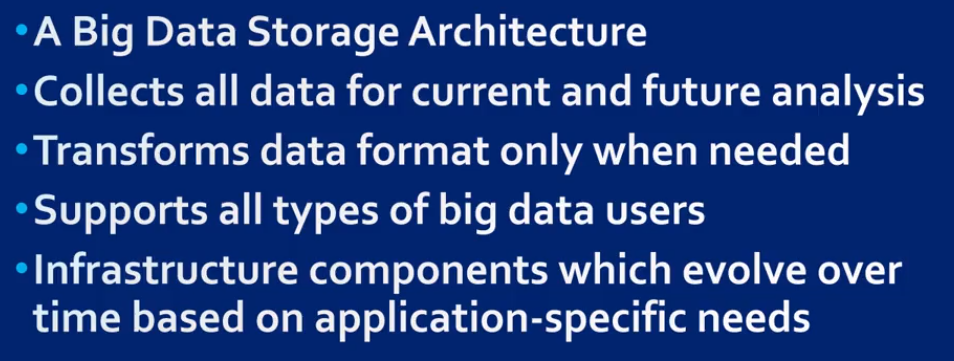
data lake summary
week5 - big data management
针对大数据,传统DBMS 需要提高的地方
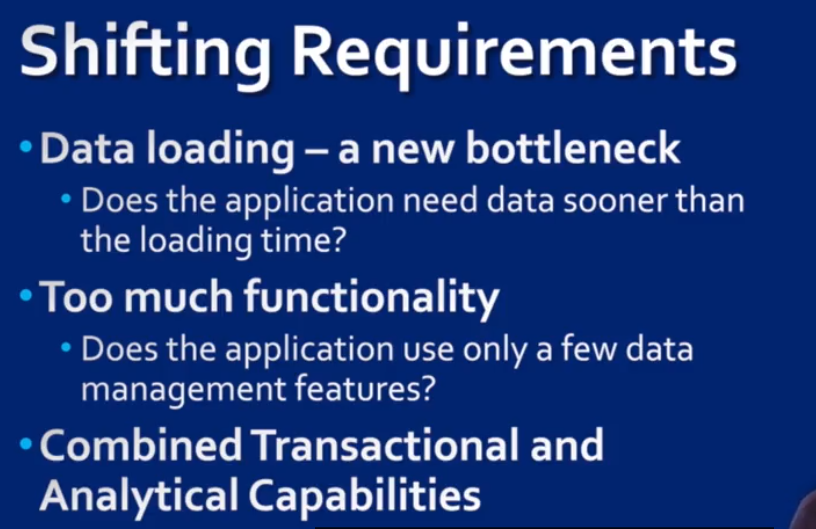
some solutiion
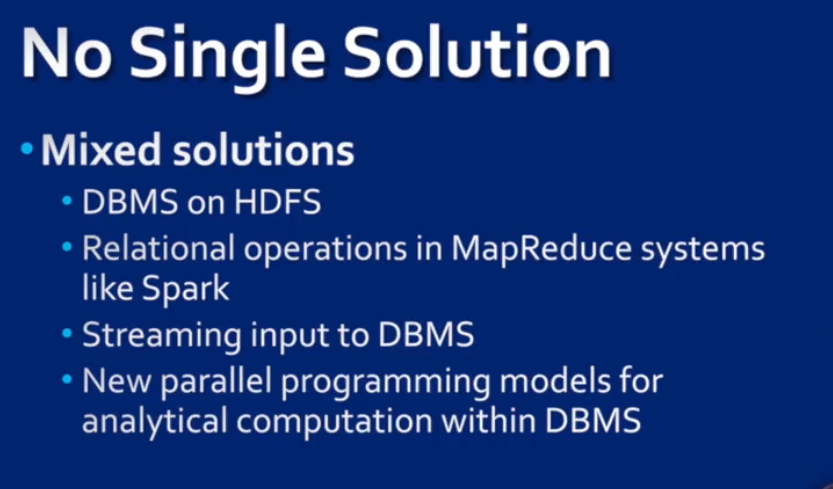
from DBMS to BDMS
BDMS 应该具有的特征

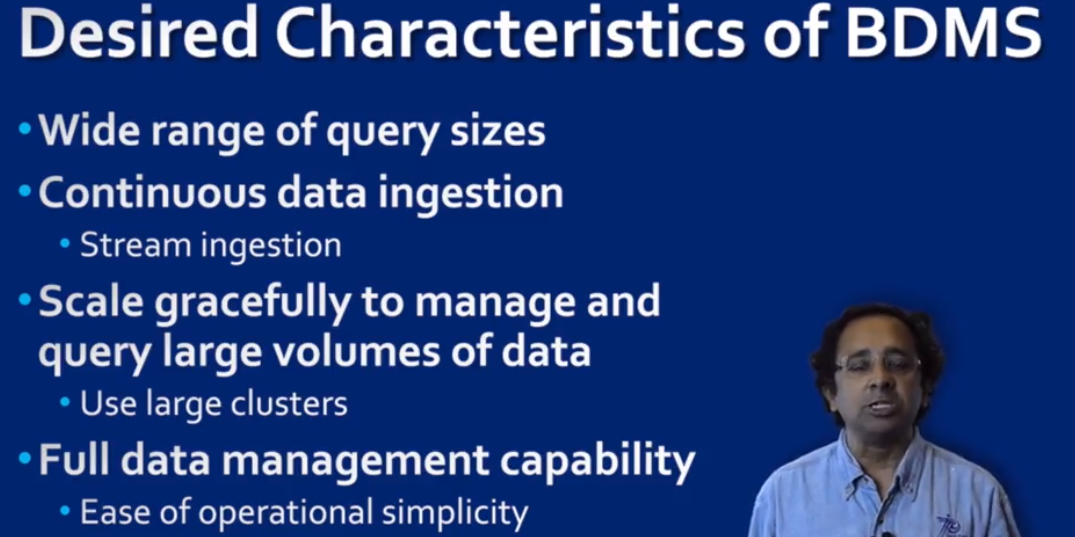

BASE 就是基于CAP理论的

一些常用的BDMS及其优缺点
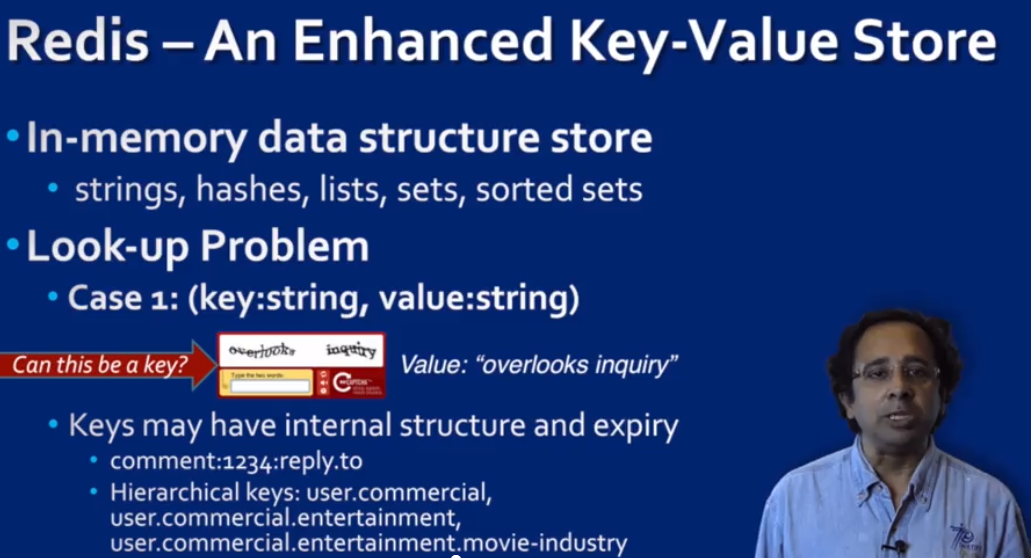
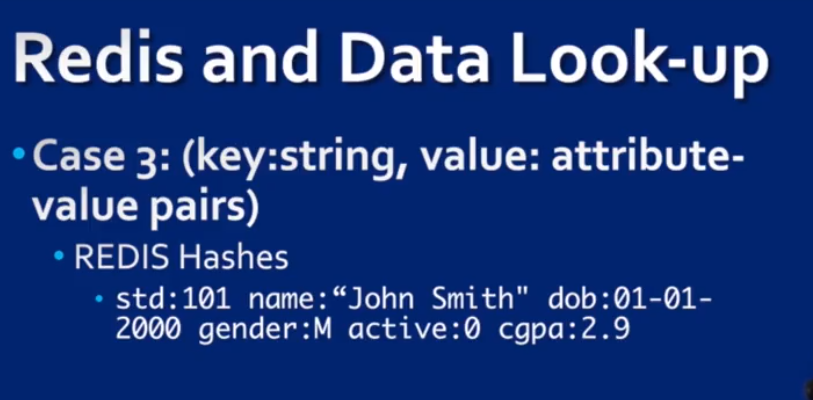
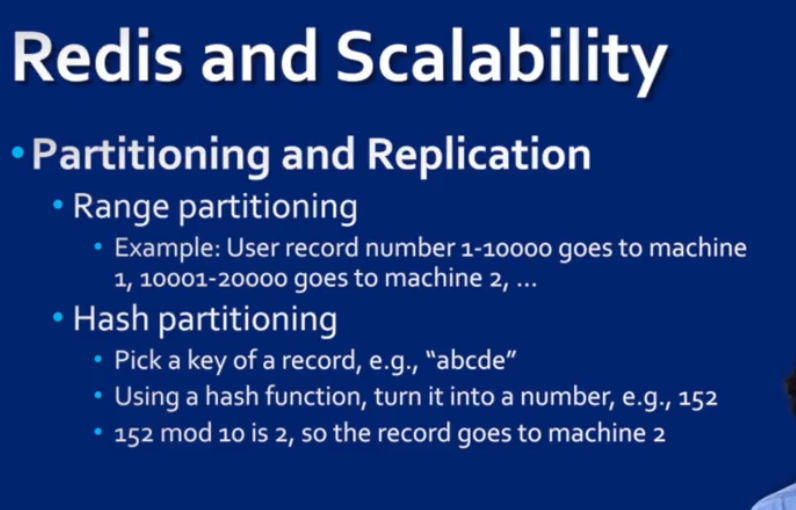
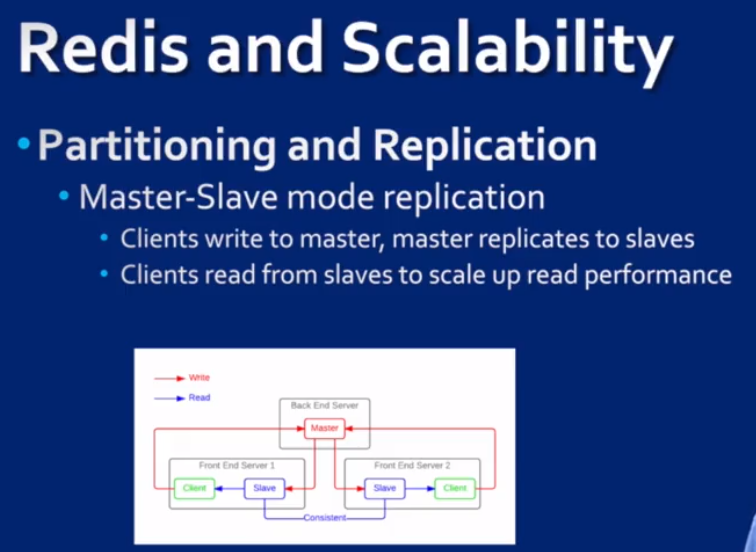
Redis: an enhanced key-value store

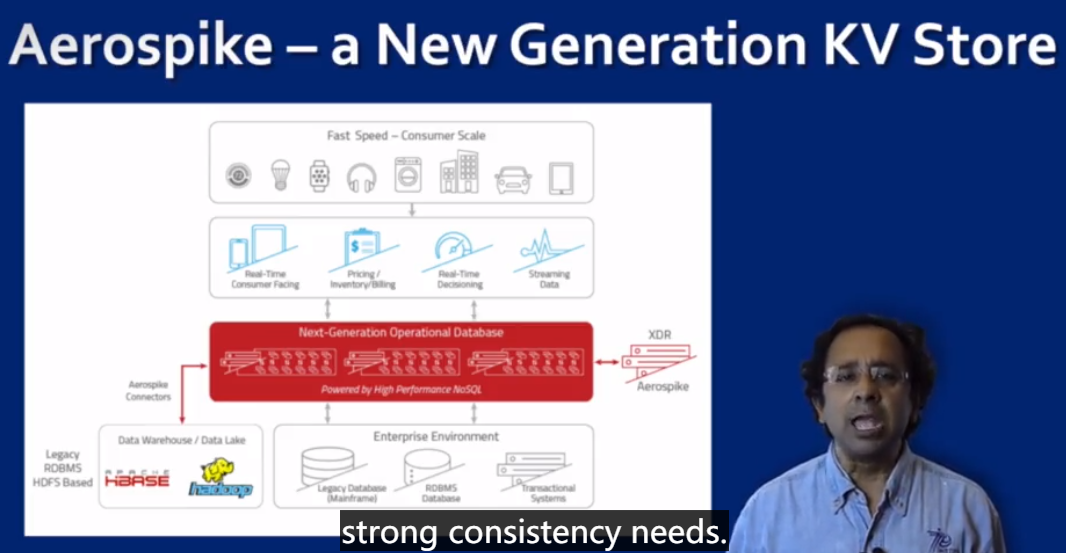
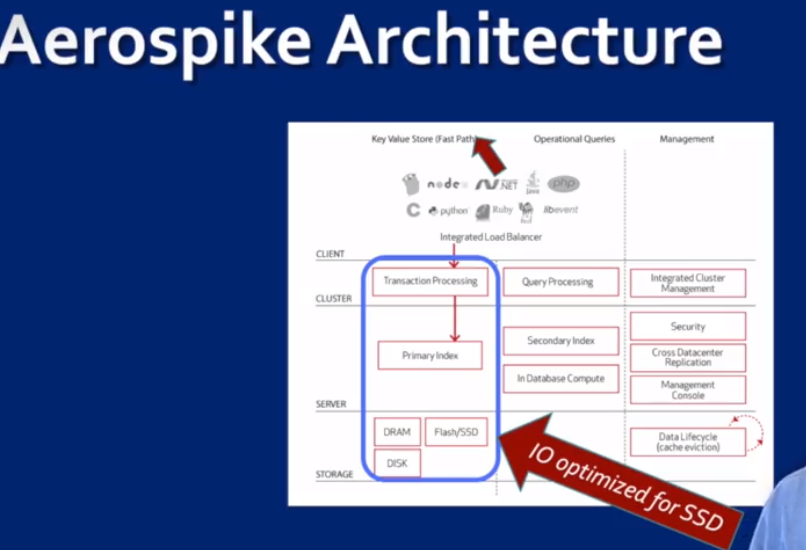
Aerospike: a new generation KV store
这是一个分布式NoSQL database + KV store. 是强一致性的


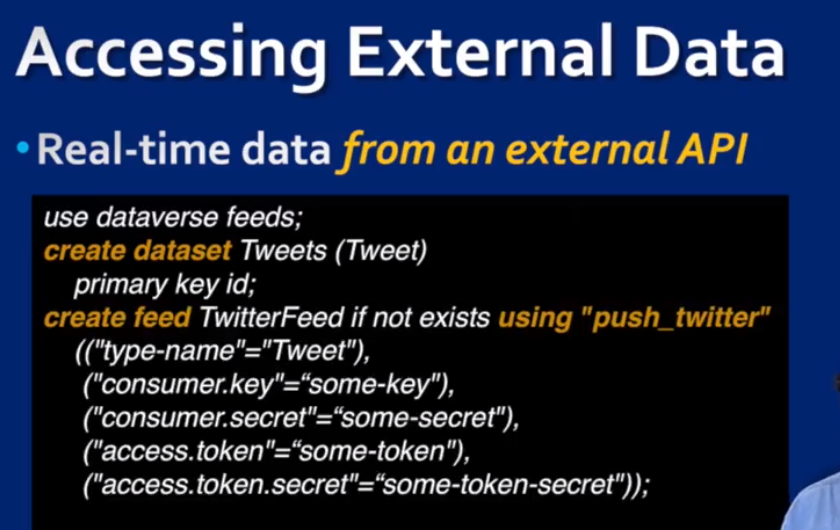
AsterixDB: a DBMS for semistructured data. 大家都知道的mongodb 以json 格式存储j数据, 这个Asterix 和 mongodb 类似. 它提供ACID保证.
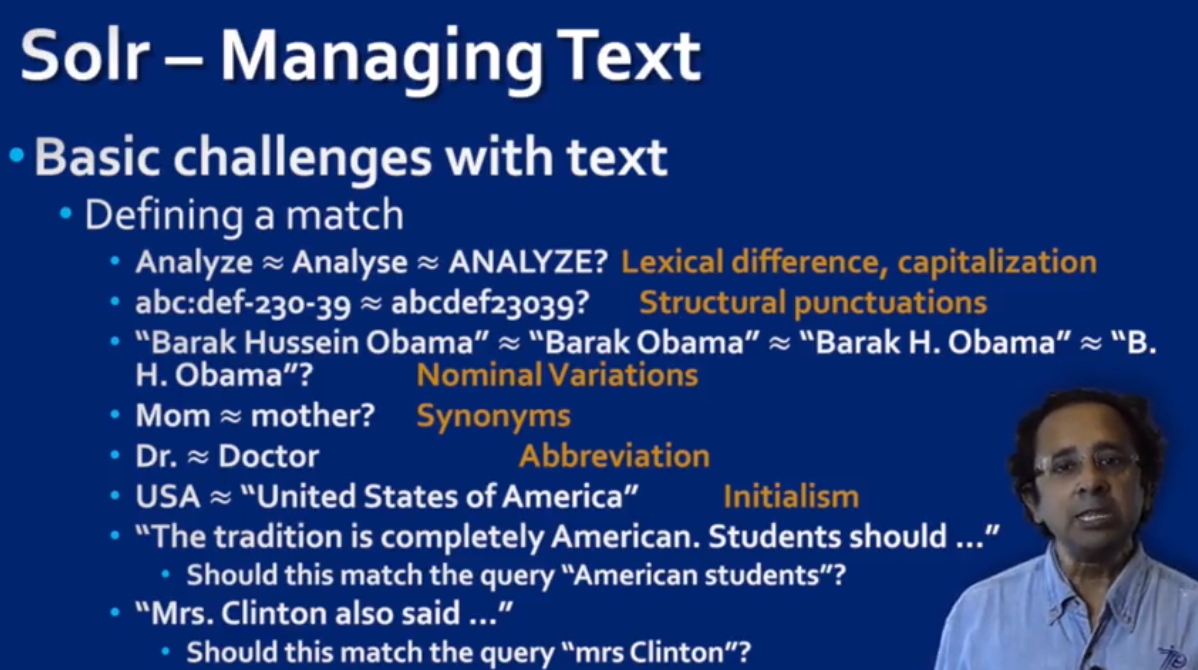
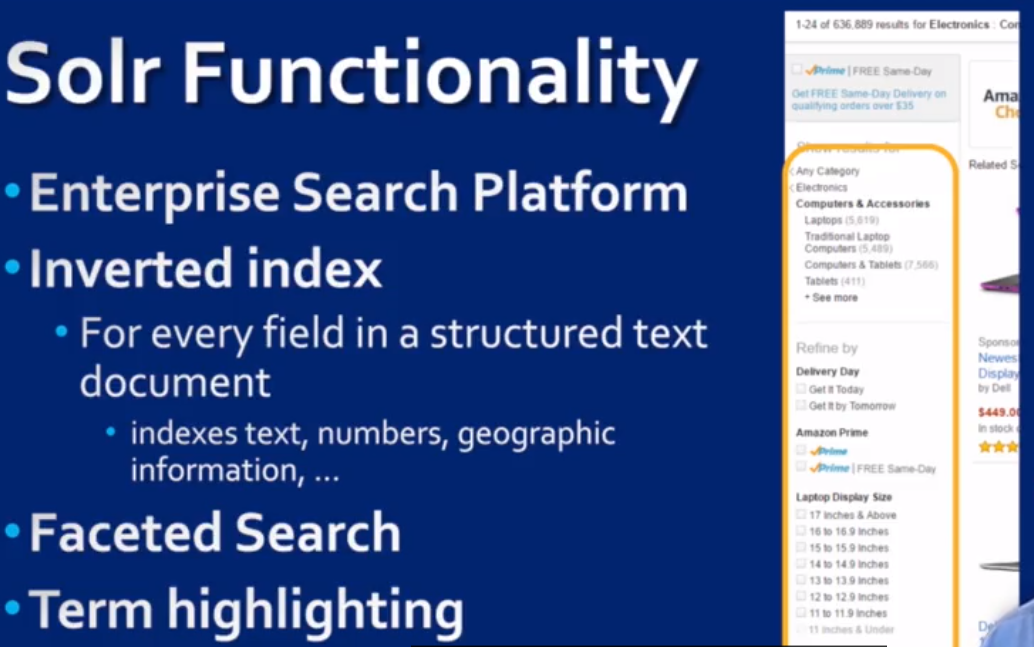
Solr : Text data searching. 基于Lucene的
应该是一种search engine, 不知道和 ES 什么区别.
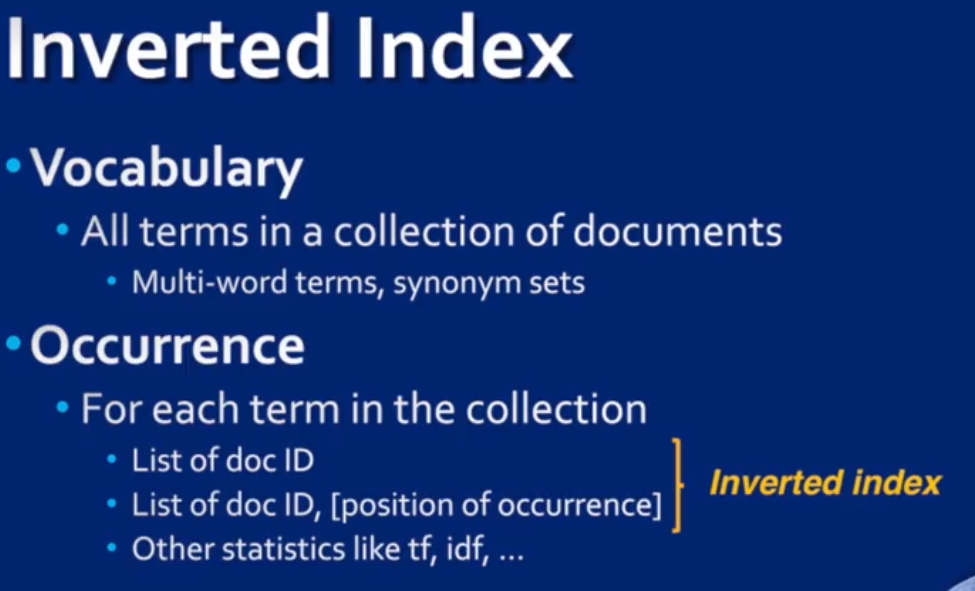
反向索引,至少要包含 doc id list, 也可以包含更多信息
除了full text search, 还有下面的功能
Vertica:a columnar DBMS

Coursera, Big Data 2, Modeling and Management Systems (week 4/5/6)的更多相关文章
- Coursera, Big Data 2, Modeling and Management Systems (week 1/2/3)
Introduction to data management 整个coures 2 是讲data management and storage 的,主要内容就是分布式文件系统,HDFS, Redis ...
- Coursera, Big Data 3, Integration and Processing (week 4)
Week 4 Big Data Precessing Pipeline 上图可以generalize 成下图,也就是Big data pipeline some high level processi ...
- Coursera, Big Data 4, Machine Learning With Big Data (week 1/2)
Week 1 Machine Learning with Big Data KNime - GUI based Spark MLlib - inside Spark CRISP-DM Week 2, ...
- Coursera, Big Data 3, Integration and Processing (week 5)
Week 5, Big Data Analytics using Spark Programing in Spark Spark Core: Programming in Spark us ...
- Coursera, Big Data 3, Integration and Processing (week 1/2/3)
This is the 3rd course in big data specification courses. Data model reivew 1, data model 的特点: Struc ...
- Coursera, Big Data 1, Introduction (week 3)
什么是分布式文件系统?为什么需要分布式文件系统? 如果文件系统可以管理用网络连接的很多个存储单元,叫分布式文件系统. 分布式文件系统提供了数据可扩展性,容错性,高并发. 这些是传统文件系统不具有的. ...
- Coursera, Big Data 1, Introduction (week 1/2)
Status: week 2 done. Week 1, 主要讲了大数据的的来源 - 机器产生的数据,人产生的数据(比如社交软件上的update, 一般是unstructed data), 组织产生的 ...
- Coursera, Big Data 4, Machine Learning With Big Data (week 3/4/5)
week 3 Classification KNN :基本思想是 input value 类似,就可能是同一类的 Decision Tree Naive Bayes Week 4 Evaluating ...
- [label][Node.js] Three content management systems base on Node.js
1. Keystonejs http://keystonejs.com/ 2. Apostrophe http://apostrophenow.org/
随机推荐
- PHP依赖注入原理与用法分析
https://www.jb51.net/article/146025.htm 本文实例讲述了PHP依赖注入原理与用法.分享给大家供大家参考,具体如下: 引言 依然是来自到喜啦的一道面试题,你知道什么 ...
- AI SegNet
SegNet,是一种基于编码器-解码器架构的深度全卷积神经网络,用于图像语义分割. 参考链接: https://ieeexplore.ieee.org/document/7803544
- 基于vue-simple-uploader封装文件分片上传、秒传及断点续传的全局上传插件
目录 1. 前言 2. 关于vue-simple-uploader 3. 基于vue-simple-uploader封装全局上传组件 4. 文件上传流程概览 5. 文件分片 6. MD5的计算过程 7 ...
- LODOP直线px转换mm变斜线
LODOP中打印项顶边距左边距,宽高,可以选择的单位很多,详细可在LODOP官网下载参考LODOP技术手册. 关于LODOP打印直线和虚线,可查看本博客相关博文:Lodop如何打印直线.Lodop打印 ...
- js 实现的页面图片放大器以及 event中的诸多 x
背景: 淘宝.天猫等电商网站浏览图片时可以查看大图的功能: 思路: 思路很简单,两张图片,一张较小渲染在页面上,一张较大是细节图,随鼠标事件调整它的 left & top; 需要的知识点: o ...
- [模板] 匈牙利算法&&二分图最小字典序匹配
匈牙利算法 简介 匈牙利算法是一种求二分图最大匹配的算法. 时间复杂度: 邻接表/前向星: \(O(n * m)\), 邻接矩阵: \(O(n^3)\). 空间复杂度: 邻接表/前向星: \(O(n ...
- Java【第五篇】基本语法之--数组
数组概述 数组是多个相同类型数据的组合,实现对这些数据的统一管理数组属引用类型,数组型数据是对象(Object),数组中的每个元素相当于该对象的成员变量数组中的元素可以是任何数据类型,包括基本类型和引 ...
- 记录一次有意思的XSS过滤绕过
我的朋友赵一天今晚给我发了一个站,跟我说他xss绕不过去,让我试试.我正好无事,就帮她看看咯. 通过赵一天发我的站点,说实话,我自己学到了很多东西,感谢大佬的教诲.今天分享出来: 站点:xxx.com ...
- Input标签使用整理
0 写在前面 对于程序而言I/O是一个程序的重要组成部分.程序的输入.输出接口,指定了程序与用户之间的交互方式.对于前端开发而言,input标签也有着其重要地位,它为用户向服务端提交数据提供了可能. ...
- java实现sftp客户端上传文件夹的功能
使用的jar: <dependencies> <dependency> <groupId>jsch</groupId> <artifactId&g ...