
新闻网大数据实时分析可视化系统项目——12、Hive与HBase集成进行数据分析
(一)Hive 概述

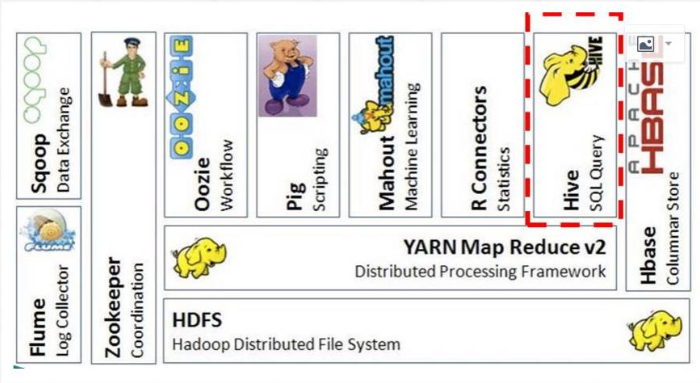
(二)Hive在Hadoop生态圈中的位置
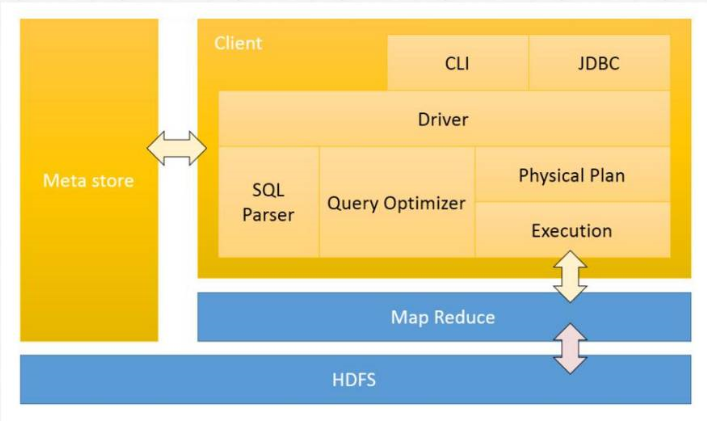
(三)Hive 架构设计
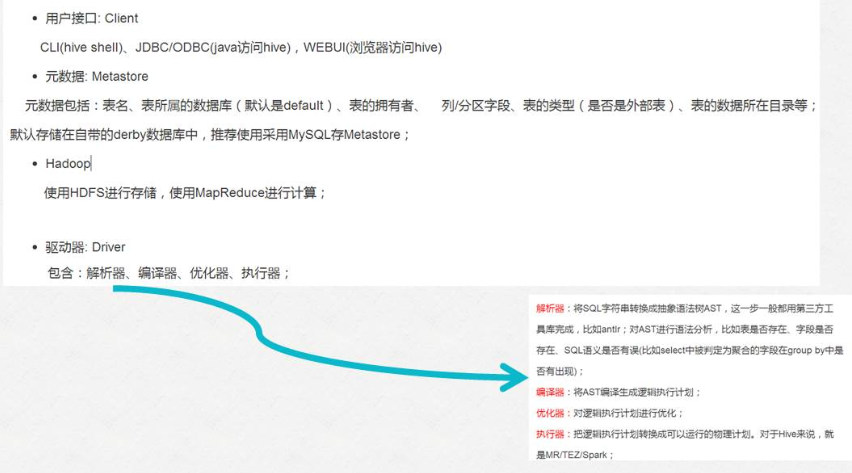
(四)Hive 的优点及应用场景

(五)Hive 的下载和安装部署
1.Hive 下载
Apache版本的Hive。
Cloudera版本的Hive。
这里选择下载Apache稳定版本apache-hive-0.13.1-bin.tar.gz,并上传至bigdata-pro03.kfk.com节点的/opt/softwares/目录下。
2.解压安装hive
tar -zxf apache-hive-0.13.1-bin.tar.gz -C /opt/modules/
3.修改hive-log4j.properties配置文件
cd /opt/modules/hive-0.13.1-bin/conf
mv hive-log4j.properties.template hive-log4j.properties
vi hive-log4j.properties
#日志目录需要提前创建
hive.log.dir=/opt/modules/hive-0.13.1-bin/logs
4.修改hive-env.sh配置文件
mv hive-env.sh.template hive-env.sh
vi hive-env.sh
export HADOOP_HOME=/opt/modules/hadoop-2.5.0
export HIVE_CONF_DIR=/opt/modules/hive-0.13.1-bin/conf
5.首先启动HDFS,然后创建Hive的目录
bin/hdfs dfs -mkdir -p /user/hive/warehouse
bin/hdfs dfs -chmod g+w /user/hive/warehouse
6.启动hive
./hive
#查看数据库
show databases;
#使用默认数据库
use default;
#查看表
show tables;
(六)Hive 与MySQL集成
1.在/opt/modules/hive-0.13.1-bin/conf目录下创建hive-site.xml文件,配置mysql元数据库。
vi hive-site.xml
<property>
<name>javax.jdo.option.ConnectionURL</name>
<value>jdbc:mysql://bigdata-pro01.kfk.com/metastore?createDatabaseIfNotExist=true</value>
</property>
<property>
<name>javax.jdo.option.ConnectionDriverName</name>
<value>com.mysql.jdbc.Driver</value>
</property>
<property>
<name>javax.jdo.option.ConnectionUserName</name>
<value>root</value>
</property>
<property>
<name>javax.jdo.option.ConnectionPassword</name>
<value>123456</value>
</property>
2.设置用户连接
1)查看用户信息
mysql -uroot -p123456
show databases;
use mysql;
show tables;
select User,Host,Password from user;
2)更新用户信息
update user set Host='%' where User = 'root' and Host='localhost'
3)删除用户信息
delete from user where user='root' and host='127.0.0.1'
select User,Host,Password from user;
delete from user where host='localhost'
4)刷新信息
flush privileges;
3.拷贝mysql驱动包到hive的lib目录下
cp mysql-connector-java-5.1.27.jar /opt/modules/hive-0.13.1/lib/
4.保证第三台集群到其他节点无秘钥登录
(七)Hive 服务启动与测试
1.启动HDFS和YARN服务
2.启动hive
./hive
3.通过hive服务创建表
CREATE TABLE stu(id INT,name STRING) ROW FORMAT DELIMITED FIELDS TERMINATED BY '\t' ;
4.创建数据文件
vi /opt/datas/stu.txt
00001 zhangsan
00002 lisi
00003 wangwu
00004 zhaoliu
5.加载数据到hive表中
load data local inpath '/opt/datas/stu.txt' into table stu;
(八)Hive与HBase集成
1.在hive-site.xml文件中配置Zookeeper,hive通过这个参数去连接HBase集群。
<property>
<name>hbase.zookeeper.quorum</name> <value>bigdata-pro01.kfk.com,bigdata-pro02.kfk.com,bigdata-pro03.kfk.com</value>
</property>
2.将hbase的9个包拷贝到hive/lib目录下。如果是CDH版本,已经集成好不需要导包。

3.创建与HBase集成的Hive的外部表
create external table weblogs(id string,datatime string,userid string,searchname string,retorder string,cliorder string,cliurl string) STORED BY 'org.apache.hadoop.hive.hbase.HBaseStorageHandler' WITH SERDEPROPERTIES("hbase.columns.mapping" = ":key,info:datatime,info:userid,info:searchname,info:retorder,info:cliorder,info:cliurl") TBLPROPERTIES("hbase.table.name" = "weblogs");
#查看hbase数据记录
select count(*) from weblogs;
4.hive 中beeline和hiveserver2的使用
1)启动hiveserver2
bin/hiveserver2
2)启动beeline
bin/beeline
#连接hive2服务
!connect jdbc:hive2//bigdata-pro03.kfk.com:10000
#查看表
show tables;
#查看前10条数据
select * from weblogs limit 10;
新闻网大数据实时分析可视化系统项目——12、Hive与HBase集成进行数据分析的更多相关文章
- 新闻网大数据实时分析可视化系统项目——18、Spark SQL快速离线数据分析
1.Spark SQL概述 1)Spark SQL是Spark核心功能的一部分,是在2014年4月份Spark1.0版本时发布的. 2)Spark SQL可以直接运行SQL或者HiveQL语句 3)B ...
- 新闻网大数据实时分析可视化系统项目——9、Flume+HBase+Kafka集成与开发
1.下载Flume源码并导入Idea开发工具 1)将apache-flume-1.7.0-src.tar.gz源码下载到本地解压 2)通过idea导入flume源码 打开idea开发工具,选择File ...
- 新闻网大数据实时分析可视化系统项目——2、linux环境准备与设置
1.Linux系统常规设置 1)设置ip地址 使用界面修改ip比较方便,如果Linux没有安装操作界面,需要使用命令:vi /etc/sysconfig/network-scripts/ifcfg-e ...
- 新闻网大数据实时分析可视化系统项目——13、Cloudera HUE大数据可视化分析
1.Hue 概述及版本下载 1)概述 Hue是一个开源的Apache Hadoop UI系统,最早是由Cloudera Desktop演化而来,由Cloudera贡献给开源社区,它是基于Python ...
- 新闻网大数据实时分析可视化系统项目——19、Spark Streaming实时数据分析
1.Spark Streaming功能介绍 1)定义 Spark Streaming is an extension of the core Spark API that enables scalab ...
- 新闻网大数据实时分析可视化系统项目——21、大数据Web可视化分析系统开发
1.基于业务需求的WEB系统设计 2.下载Tomcat并创建Web工程并配置相关服务 下载tomcat,解压并启动tomcat服务. 1)新建web app项目 创建好之后的效果 2)对tomcat进 ...
- 新闻网大数据实时分析可视化系统项目——15、基于IDEA环境下的Spark2.X程序开发
1.Windows开发环境配置与安装 下载IDEA并安装,可以百度一下免费文档. 2.IDEA Maven工程创建与配置 1)配置maven 2)新建Project项目 3)选择maven骨架 4)创 ...
- 新闻网大数据实时分析可视化系统项目——8、Flume数据采集准备
Flume是Cloudera提供的一个高可用的,高可靠的,分布式的海量日志采集.聚合和传输的系统,Flume支持在日志系统中定制各类数据发送方,用于收集数据:同时,Flume提供对数据进行简单处理,并 ...
- 新闻网大数据实时分析可视化系统项目——7、Kafka分布式集群部署
Kafka是由LinkedIn开发的一个分布式的消息系统,使用Scala编写,它以可水平扩展和高吞吐率而被广泛使用.目前越来越多的开源分布式处理系统如Cloudera.Apache Storm.Spa ...
随机推荐
- windows 下安装chrome 调试iphone插件 ios-webkit-debug-proxy
必备: 1. .NET Framework 4.5 及以上版本 2.powershell 5.1及以上版本 3.可正常访问 https://raw.githubusercontent.com/luk ...
- 微服务架构中的Redis
了解如何将Redis与Spring Cloud和Spring Data一起使用以提供配置服务器,消息代理和数据库. Redis可以广泛用于微服务架构中.它可能是少数流行的软件解决方案之一,你的应用程序 ...
- Flask - app.debug=True,python manage.py和export FLASK_DEBUG=True,flask run的不同。
TL;DR,可以直接看下面的总结 问题1:为什么app.config['DEBUG'] = True,然后flask run并没有开启debugger和reloading,而直接运行脚本(python ...
- Debian9安装Metasploit
参考博文:https://www.jianshu.com/p/ea0629b9e367 0x0 添加Kali源 deb http://http.kali.org/kali kali-rolling m ...
- 吴裕雄 python 神经网络——TensorFlow TFRecord样例程序
import numpy as np import tensorflow as tf from tensorflow.examples.tutorials.mnist import input_dat ...
- N3K异常重启(案例)
在实际的情况下,有时候会遇到设备无故重启的问题,这个时候,我们需要判断一下重启的根本原因是什么,是否有规避的方法等. 这里记录了几个N3K异常重启的问题. 案例1: 设备型号:N3K-C3048TP- ...
- 文件的读取与保存(try-with-resource优雅关闭)
借鉴:https://www.cnblogs.com/itZhy/p/7636615.html 一.背景 在Java编程过程中,如果打开了外部资源(文件.数据库连接.网络连接等),我们必须在这些外部资 ...
- Python版GPA计算器
最近在网申投简历时遇到一个需要计算GPA的问题,想起自己在上学时写的Excel公式版GPA计算器略显low,而且操作也比较复杂,于是一时兴起,写了个Python版的,在此分享给大家,也算是跟上时代的浪 ...
- SpringBoot实现restuful风格的CRUD
restuful风格: 百度百科: RESTFUL是一种网络应用程序的设计风格和开发方式,基于HTTP,可以使用XML格式定义或JSON格式定义.RESTFUL适用于移动互联网厂商作为业务使能接口的场 ...
- MySQL 之单表查询
数据库数据: # (1) 创建数据表 create table employee( id int primary key auto_increment, emp_name char(12) not n ...